Deepseek V3 国货之光 开源之光
(如果说国产开源 7B、14B 大模型是小学生和初中生,在长上下文理解能力和稳定性方面都有差距。那么 30B 和 72B 就像高中生和大学生,两者的基础能力差不多,只是 14B 在某些专业能力上更强。而 Deepseek V3 671B 在某些方面已经超过了 ChatGPT4,点赞!)
国产开源大模型
国产开源大模型已经在世界舞台上有一席之地。不谈原创性,如果说涉及到中文语境,国产大模型无论是 GLM,还是 Qwen 都有不错的口碑,特别是 Qwen 2.5 系列。如今又多一个 Deepseek V3 补足了千亿大模型的空缺。
如果是 7B 和 14B 是小学生和中学生,他们在作文方面发挥不太稳定,而且 14B 写作长度(实际能够有效理解的提示词 tokens 数)要明显好于 7B。我们在很多场景下都印证了这个现象,2k 以内的提示词可能不太明显,上了十几 K 后,两者的理解力明显产生差距。
到了 30B 和 72B,就像高中生和大学生,在基础方面能力差距不大,某些专业场景下会有区分。当然对于普通企业内部使用,72B 也基本已经见顶。
但这次发布的 Deepseek V3 千亿级大模型 - 671B,又让我大开眼界。在几个实际应用场景,长提示词上下文 + 一定逻辑推理能力的场景下,竟然要好过 ChatGPT4,点赞!
为什么不谈闭源模型?因为国产闭源模型跟 OpenAI 和 Claude 还是有明显差距。
Deepseek V3
以下是 Andrej Karpathy 对 Deepseek V3 的评价:
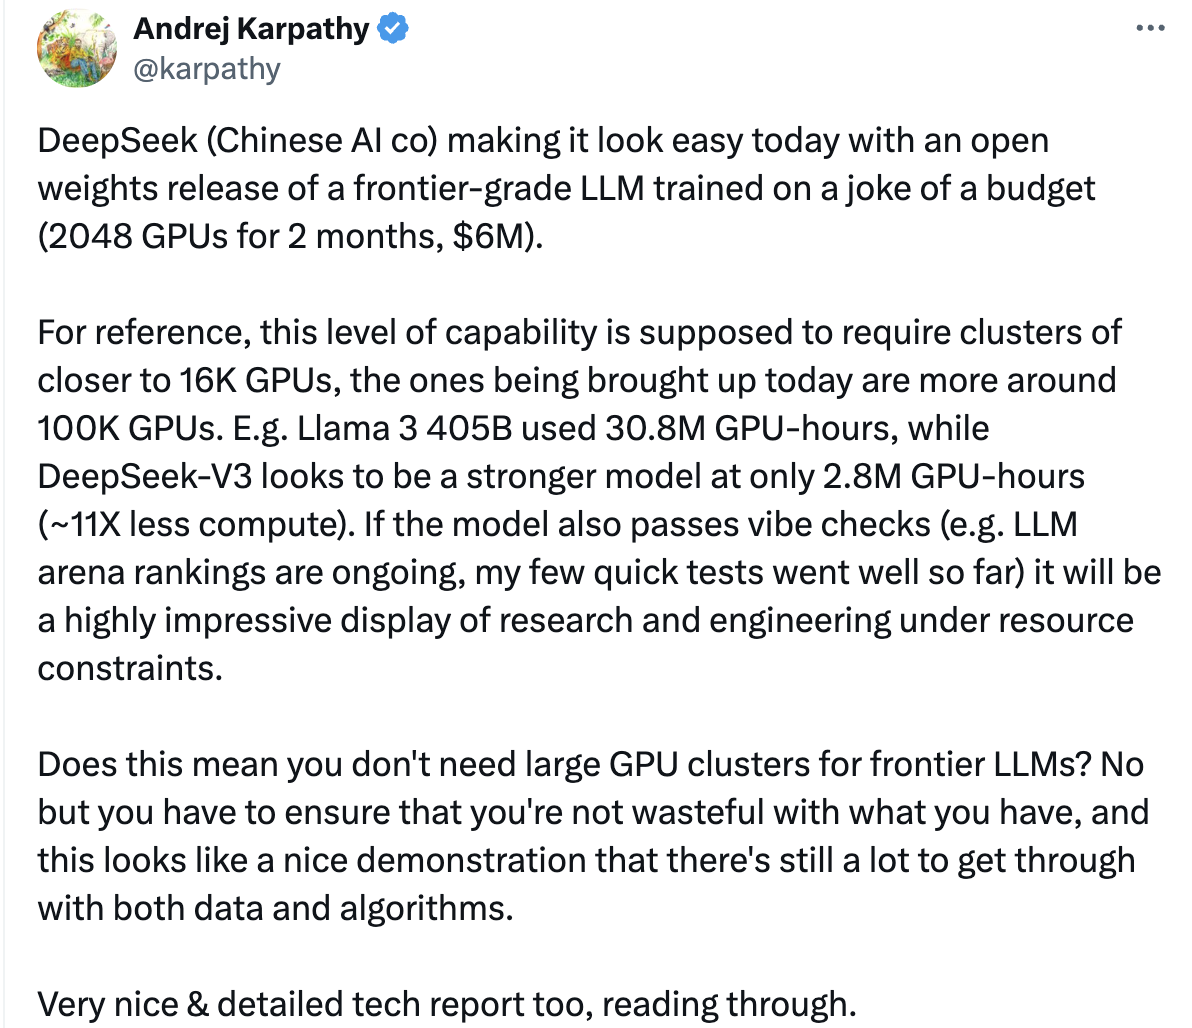
Deepseek V3 在模型能力上已经完全不输国产闭源模型,以下是个人主观论断:
如果不考虑访问互联网(tool use)以及应用交互,光从模型能力来看:
DeepseekV3 > 豆包~Kimi ~ GLM4
从整体使用体验而言:
Kimi ~ 豆包 > GLM4 ~ DeepseekV3
各路媒体把 Deepseek 称作大模型界的拼夕夕,把 token 价格打下来了,对于使用者而言当然是好事。Deepseek 此篇论文(DeepSeek-V3 Technical Report)把各种细节方面的提升展露开来,诠释 Deepseek V3 是如何用 11 分之一(见上图 Andrej Karpathy twitter)的价格被打造出来的,让你能够更加安心地 “食用”。
对于一个程序员而言,即使没有模型训练、CUDA 编程相关经验,但读到 DualPipe 算法(类似 CPU multi-stages pipeline)以减少 pipeline bubbles,维持一定比例的 computation-to-communication 就能达到接近无损的全局通讯,就感到十分亲切,不免会心一笑。
模型训练过程中涉及大量工程技术。虽然工程技术对于模型最终能力可能帮助不大,但却能最大化利用现有算法和硬件,减少金钱和时间的投入。
下面我简要的来看一下 Deepseek V3 的几个重要技术和提升点:
模型架构
Multi-Head Latent Attention
Multi-Head Latent Attention 的核心思想是在模型推理时,对注意力(attention)的 query /key/value 进行低秩联合压缩,从而在减轻计算量的同时减少了 KV 缓存的使用。这也是它相较早前 Multi-Head Attention 在 GPU 计算和显存使用方面的优势。
Mixture of Experts
在讨论 Deepseek V3 创新的 Auxiliary-Loss-Free Load Balancing 路由算法之前,首先来简单介绍一下 MoE(mixture of experts)模型的基本思路。
现有的大模型基本都是基于 Transformer 架构,Deepseek V3 也不例外。MoE 的架构主要体现在 FFN(Feed-Forward Network)模块上。MoE 中将原先 FFN 称作 expert,在模型推理时,新增一个 Router 模块用于将输入路由到 个 routed experts,以及几个要固定计算的 shared exports。
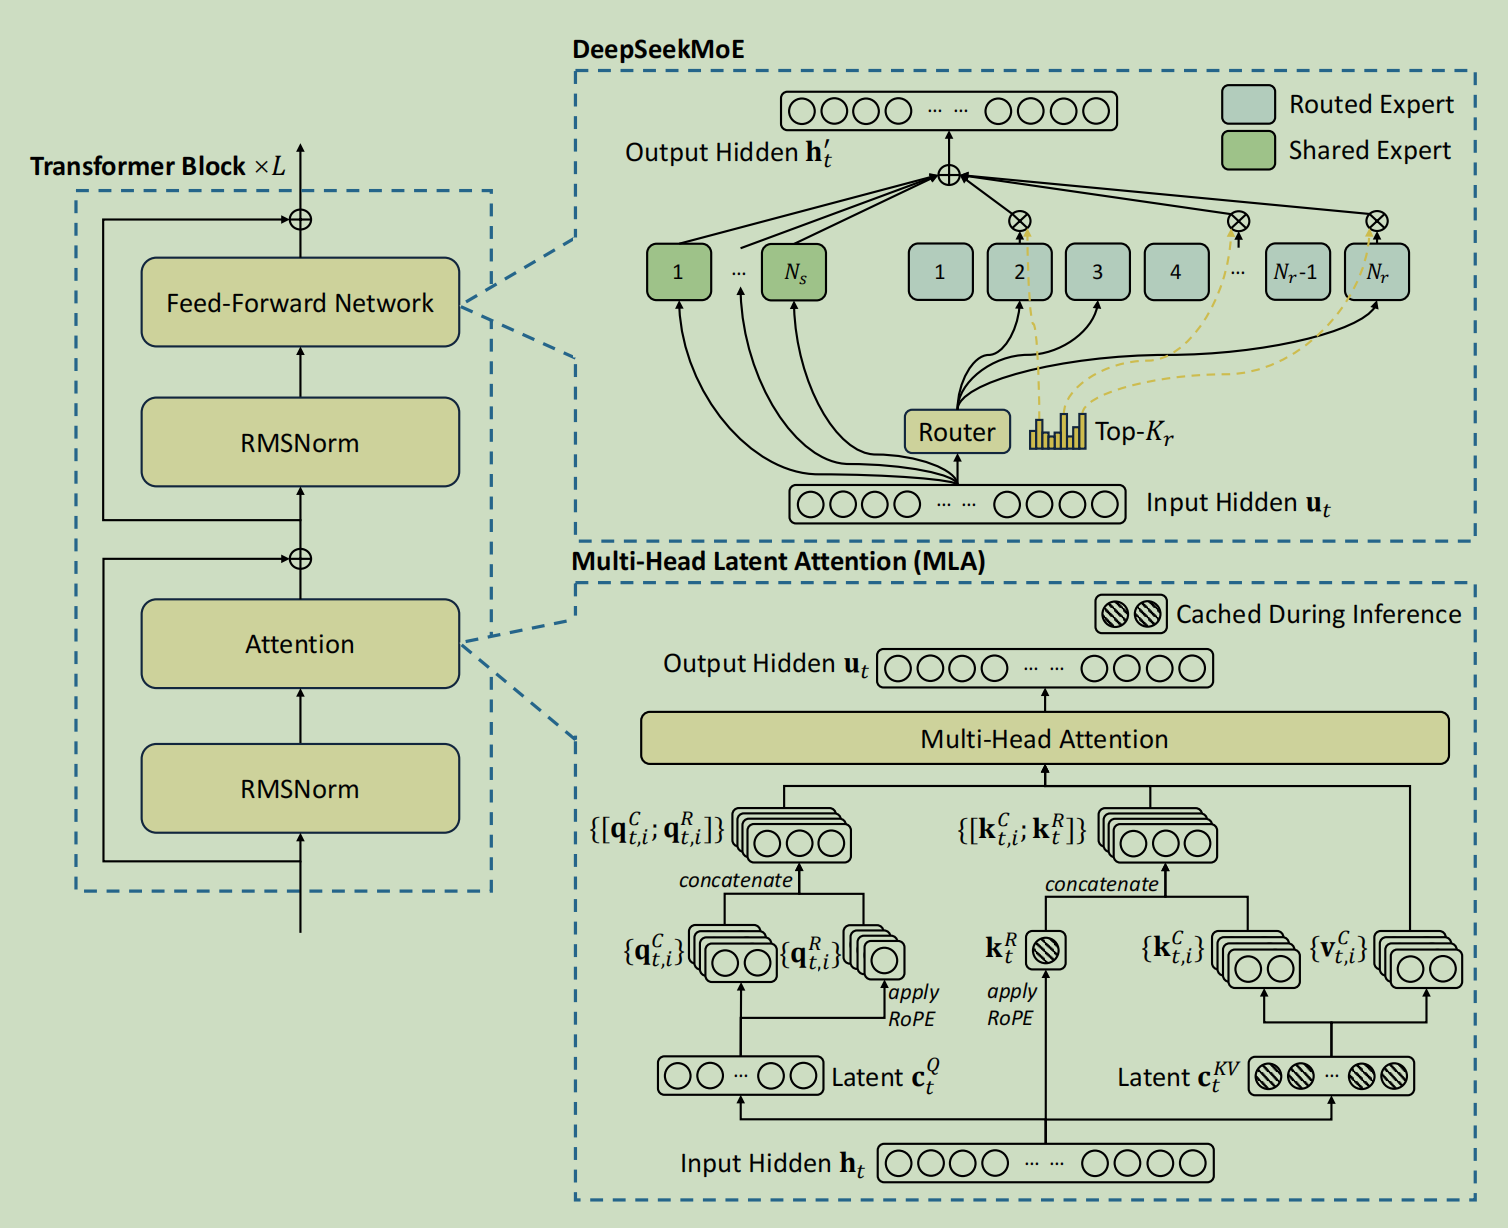
Deepseek V3 共有 61 个 Transformer Block,除去前 3 个 Block 外,其他 58 个 FFN 都使用 MoE 架构。每个 FFN 包含 1 个 shared expert 和 256 个 routed experts,推理时会路由到其中 8 个 routed experts。为什么选择 8 这个数值?压榨 GPU、通讯的性能是其中一部分的考量。后续还会在 computation-to-communication 优化中再次提及。
Auxiliary-Loss-Free Load Balancing
对 MoE 架构有一定了解的情况下,接下来我们来看一下 Router 模块中 Auxiliary-Loss-Free Load Balancing 算法。
如果说 Multi-Head Latent Attention 只是 Deepseek 团队使用现有技术,那么 Auxiliary-Loss-Free Load Balancing 则是对 MoE 模型内部 experts 路由算法的一种创新优化。
既然是优化,那就有优化前的主体部分。基本的 DeepseekMoE 路由算法,公式如下:
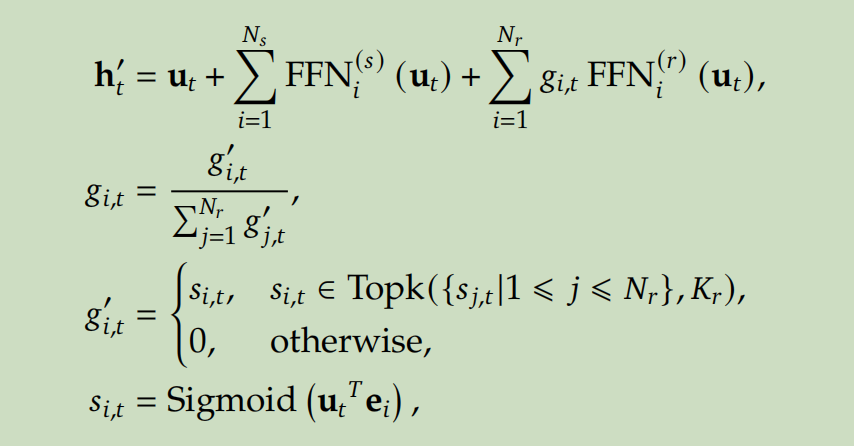
公式得从下往上看。
- 先计算隐藏层输入与每个 routed export 处理过的质心点积,再经过 sigmoid 变化后获取亲和度得分 。类似计算了两个向量余弦夹角,达到求解向量相似度(距离)的作用。
- 其次,选取 top k 个得分,其他置为 0,便于后续操作。
- 然后归一化得到最终得分
- 最后结合输入 ,shared experts 输出,routed experts 输出,得到最终输出
Auxiliary-Loss-Free Load Balancing 优化算法的思想也比较直接,在现有决定 routed exports 路由的亲和度得分 上添加了一个偏置 。模型训练过程中,如果发现某个 export 被路由到的次数过于频繁,那么会适当(由超参数 𝛾 控制)减少 值。 反之,则会增加 值。但 值不参与模型计算,只用于 TopK 个得分选取,不影响参与后续计算的亲和度得分 。
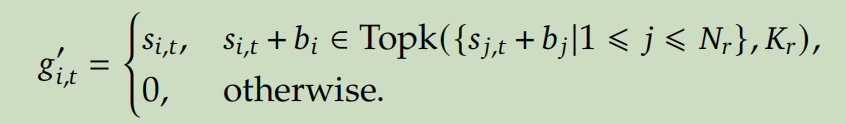
有没有一种似曾相识的感觉,前一篇模型泛化能力提升:正则化技术的理论与实现涉及 AdamW 优化器的 weight decay 算法,两者都是类似的 “中庸” 算法。
(未完待续) 接上斜杠青年 DeepseekV3
Multi-Token Prediction (MTP)
Deepseek V3 在训练中采用了 Meta 提出的 Multi-Token Prediction(Better & Faster Large Language Models via Multi-token Prediction)算法,并做了部分改进。
我们先来介绍 Meta 的 MTP 算法。
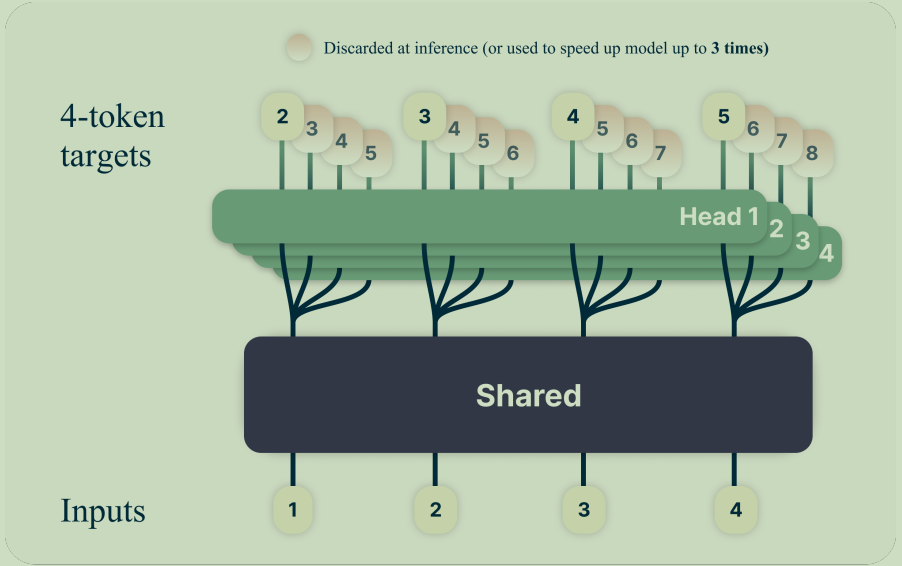
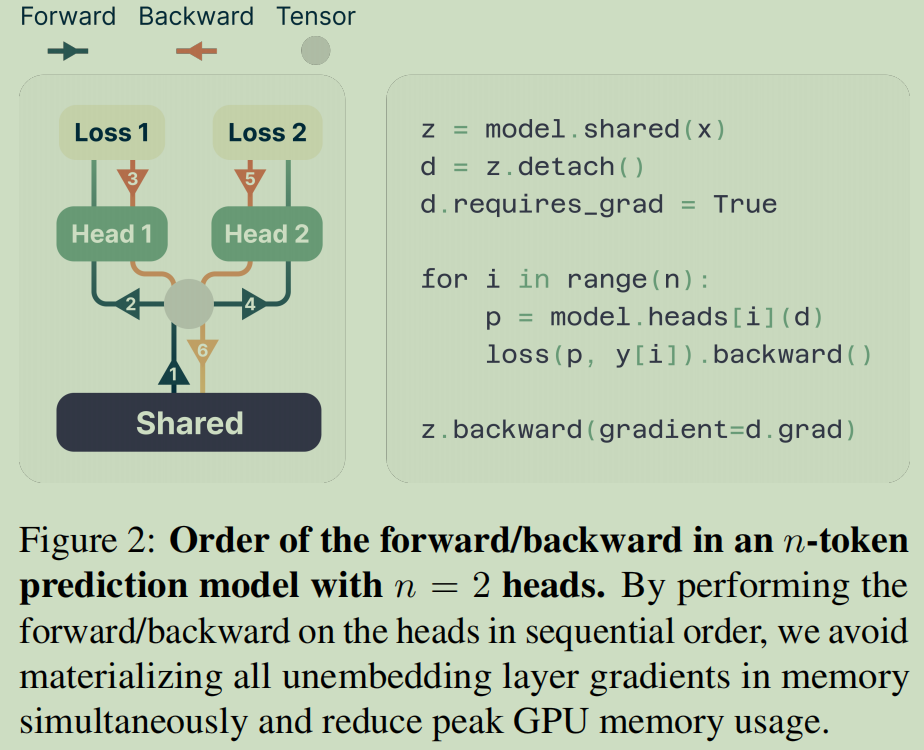
MTP 算法可以简单理解为,在原有模型之上增加 n 个 heads(Head 是一种 transformer layer,参考# 大语言模型基础(一) — Transformer),用于生成后续 n 个 tokens。 这就是 MTP 算法跟传统的基于 Transformer 大模型每次只预测一个 token 的最主要的区别点。
上面展示了 MTP 算法的模型结构,图 3 是计算公式上的区别,集中在损失函数的计算方面。
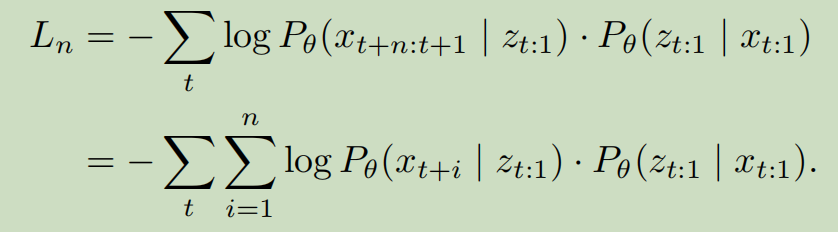
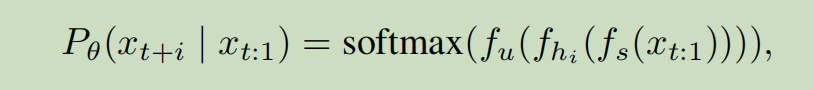
其中 是用于训练的预料 sequence 的前 t 个 tokens,经过原 LLM 模型 后生成隐藏层 。隐藏层 经过每个 的计算得到的下 i 个 token ,且都是独立,也就是说 依赖于前 t 个 token,与最近前 i - 1 个 token (s) 无关。
而 i 个 只在模型训练损失函数计算时会用到,模型用于推理时往往只采纳第一个 head 的结果,后面几个 head 的结果会被直接丢弃。
MTP 算法整体上有种类似下棋时 “走一步,看三步” 的意味,可惜的是后三步间没有关联。
Deepseek V3 也就是看到了这个问题,对 MTP 做了对应优化,增加了后几步的因果性,如下图所示:
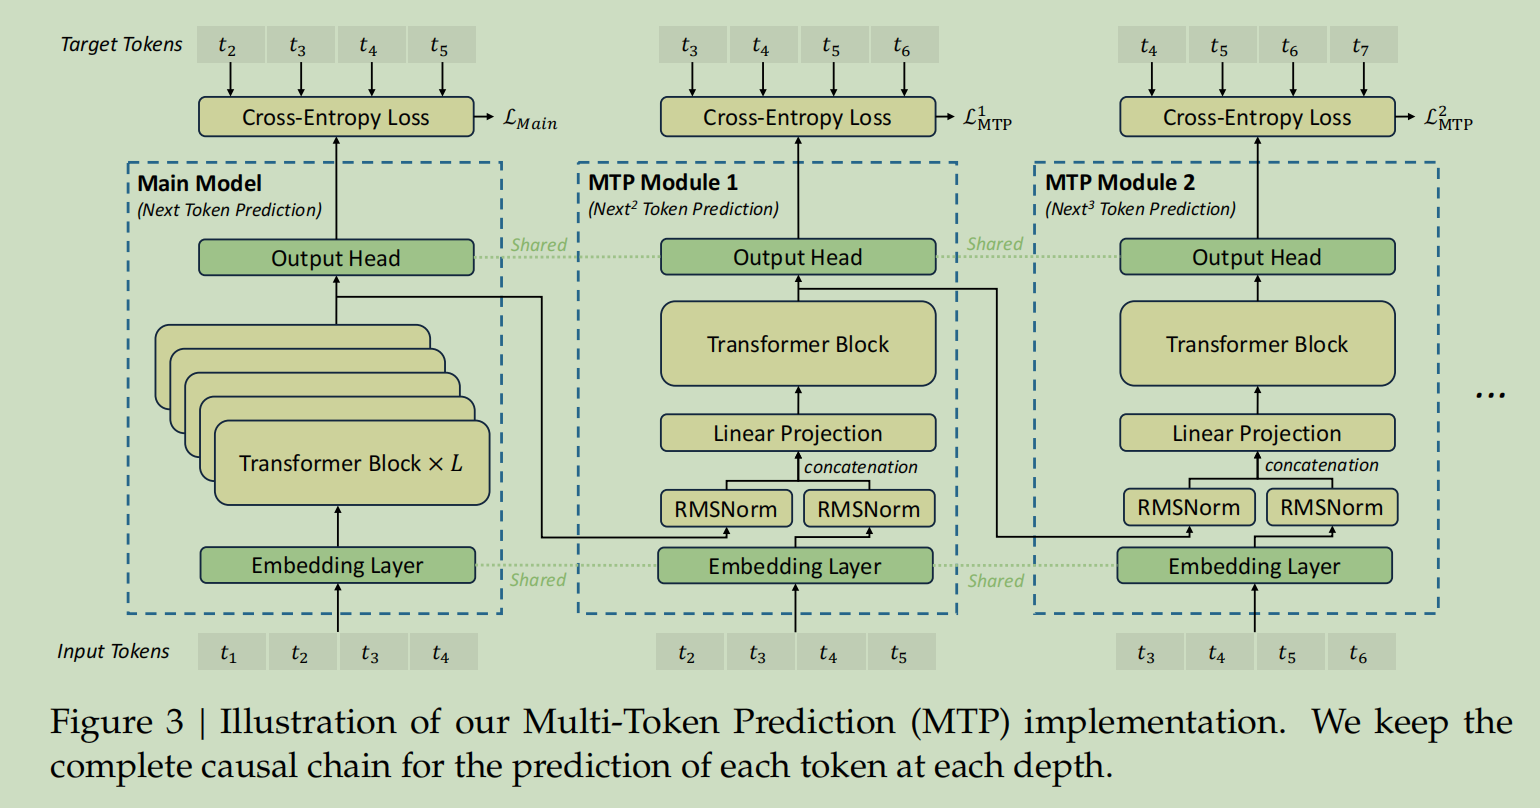
这里需要注意的是,图中 “Output Head” 与 MTP 算法的 head 无关。 MTP 算法中的 head 对应的是 Deepseek V3 中的 “Transformer Block”。Deepseek V3 还为因果性添加了 RMSNorm 和 Linear Projection,用于处理上一个 MTP Module 的结果,使 MTP Module 产生因果性。
同样,Deepseek V3 模型在做推理时也只用了 Main Model 的结果。
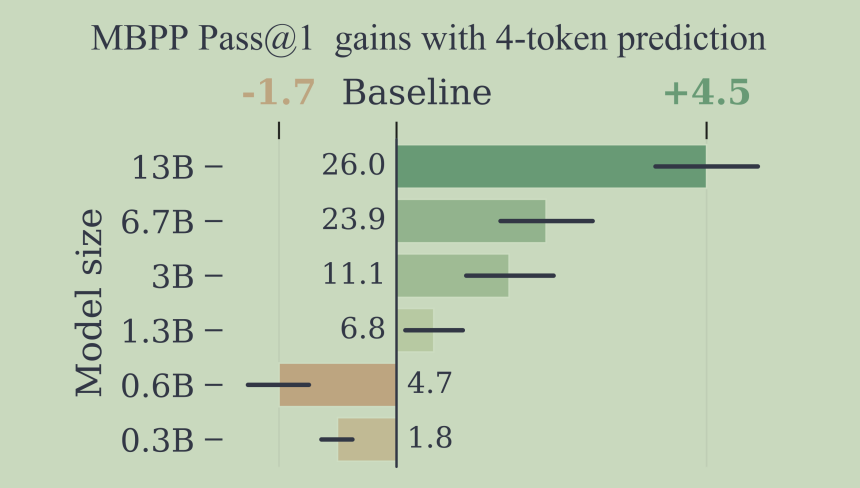
另一个在 Meta 的 MTP 论文(Better & Faster Large Language Models via Multi-token Prediction)中提及,但是 DeepSeek-V3 Technical Report 中没有提及的一个有意思的实验结论:参数量越大,MTP 算法效果越好,如下图。
分布式流水线
Deepseek V3 创新使用的 DualPipe and Computation-Communication Overlap 技术,一定程度上和 CPU 的指令流水线,有异曲同工之妙。因此我把这种技术称为分布式流水线,与指令流水线相呼应。
既然有 CPU 指令流水线,GPU 作为一种特殊的中央处理器,也有自己的指令流水线,只是各自达到的目标不同,这里不加赘述。计算机结构大多都是自相似的,大致有计算单元、存储单元、连接总线等。
流水线分解
分布式流水线是对指令流水线的更加宏观化的体现。要成为流水线的第一步是划分流水节点,这样才能做到独立的流水节点间的并行(overlap),从而 达到最大程度利用资源的目的。迭代化的软件工程也是如此,产品需求、开发、测试,不可能说是需求评审完,产品就没事做了,开发、测试同理。
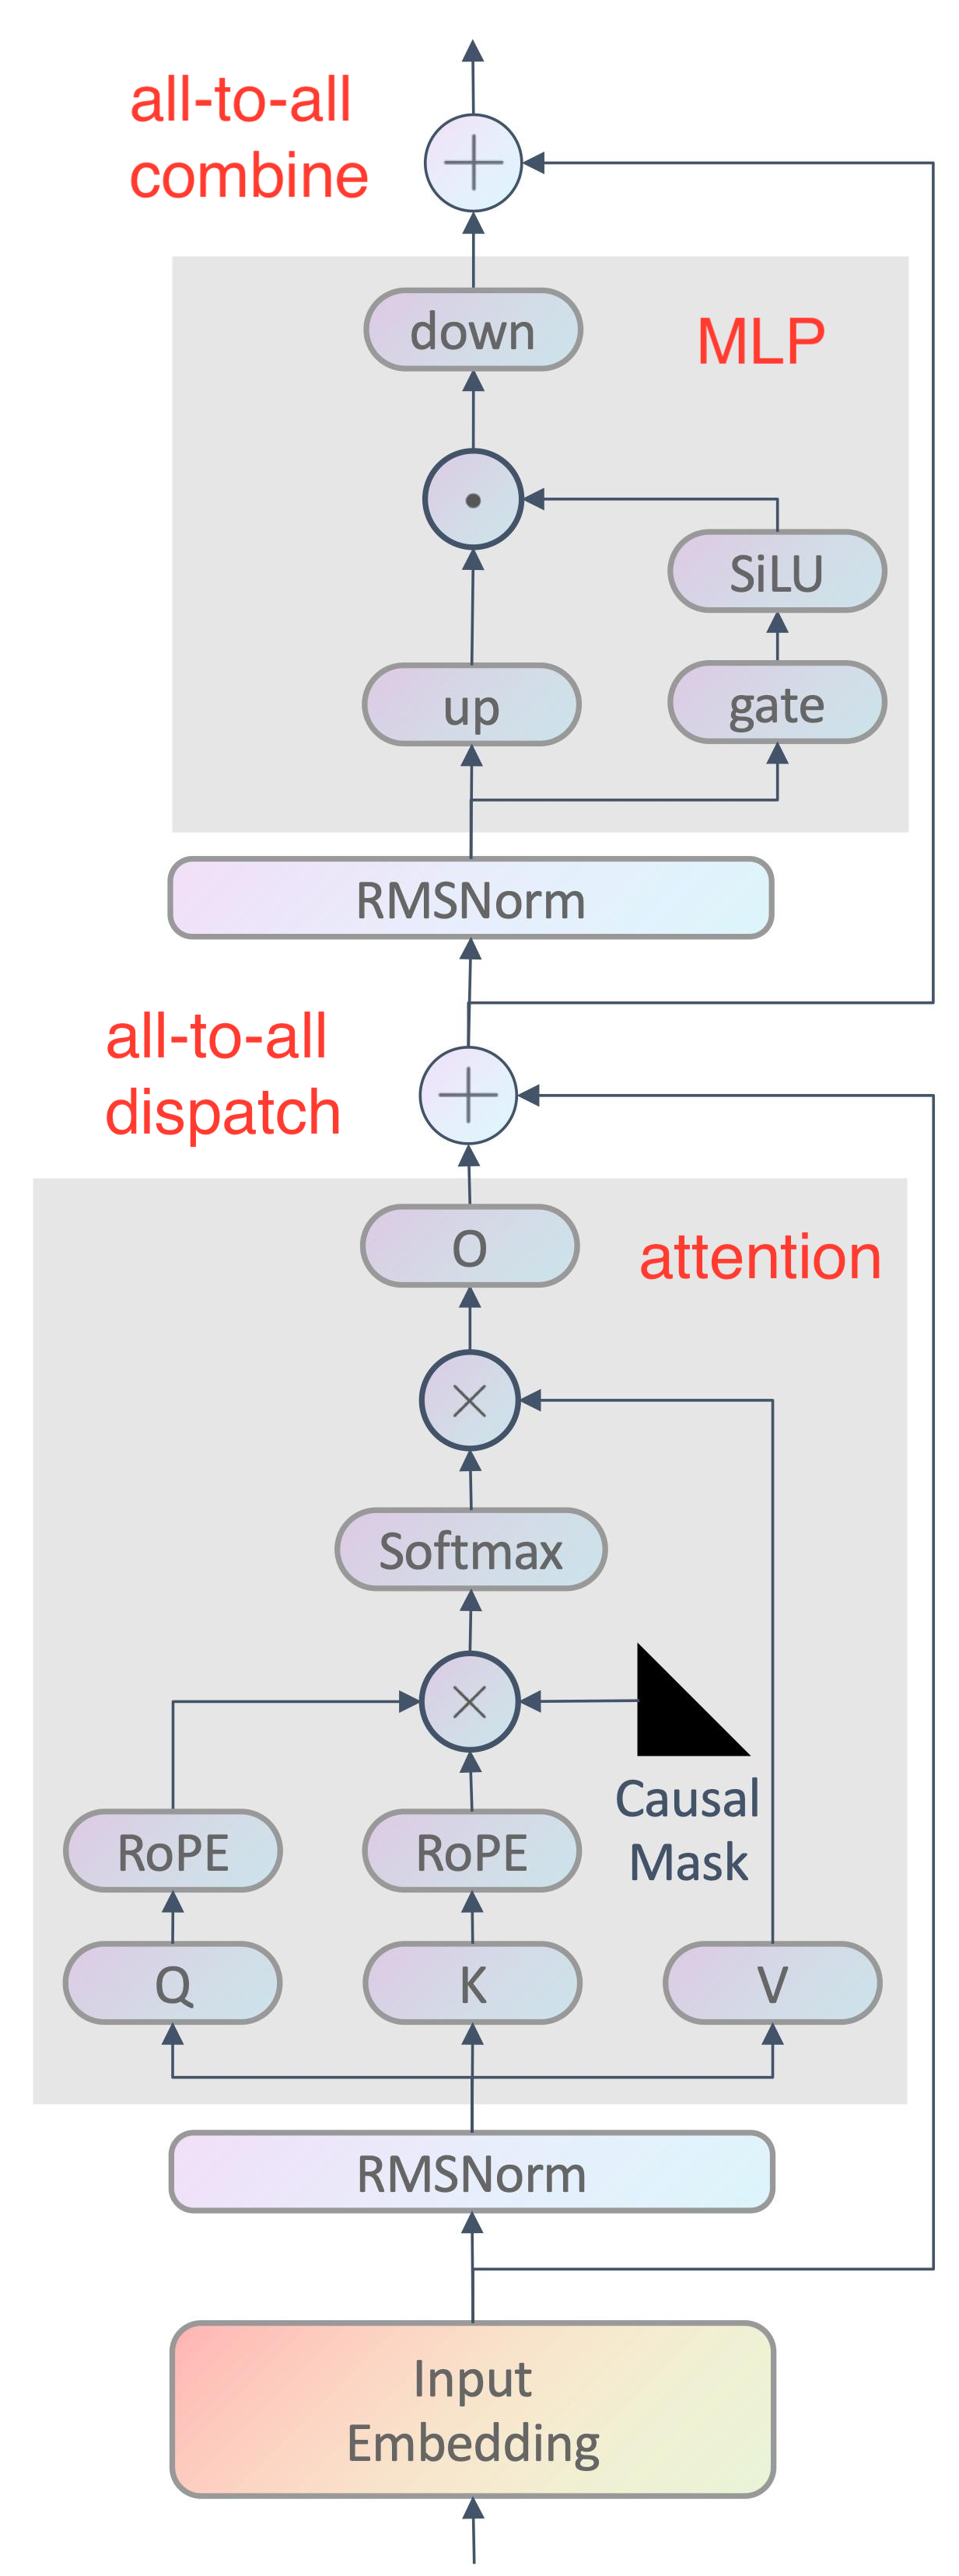
CPU 指令流水线简化来看有取指、译码、执行、访存、写回几个节点,对应本文的分布式流水线的注意力计算(attention)、整体派发(all-to-all dispatch)、MLP 层计算(MLP)、整体组装(all-to-all combine),其实就是 “图 4 MPT” 中 Transformer Block 分解后的节点。
以开源 Llama 模型为例,Transformer Block 分解后的 4 个节点与 Llama 模型的对应关系如下图所示:
流水线节点 overlap
分解完流水线节点,接下来就要压榨每个节点性能了。原理也很简单,就是别让它们空下来。
下图是 CPU 流水线的一个例子,将一个个原子 CPU 指令分解为不同节点,不同节点 overlap 起来使用 CPU 的不同组件在同一个时钟周期执行。
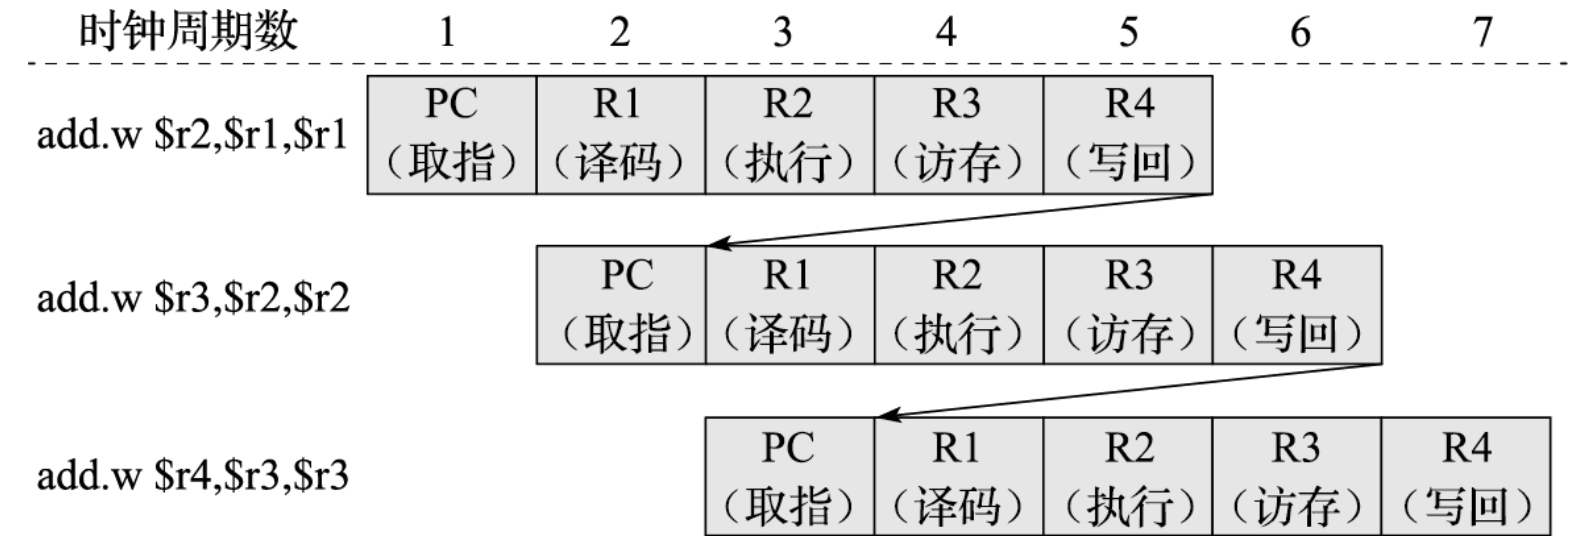
当然 CPU 指令流水线还有很多细节需要处理,比如遇到分支指令,或者某些指令需要阻塞等等,我们就不展开下去了。
那么 Deepseek V3 在工程上改进而来的分布式流水线(DualPipe and Computation-Communication Overlap)也就容易理解了。只是此时的流水线节点变成了 attention 计算、分派、MLP 计算、组装,并进一步把 forward 和 backward 分开了而已。
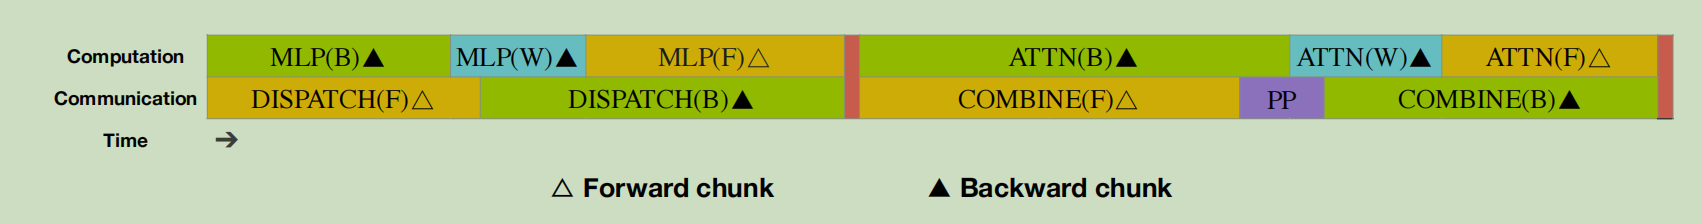
归纳起来就是要维持一个合理的 computation (attention/MLP)-to-communication (dispatch/combine) 比,而且会随着硬件能力、模型算法的变化而变化。比如论文采用了 H100 GPU、NVLink 作卡间通讯(GPU 服务器内)、IB 作分布式 node 间通信(GPU 服务器间),这种硬件配置以及采用的模型。
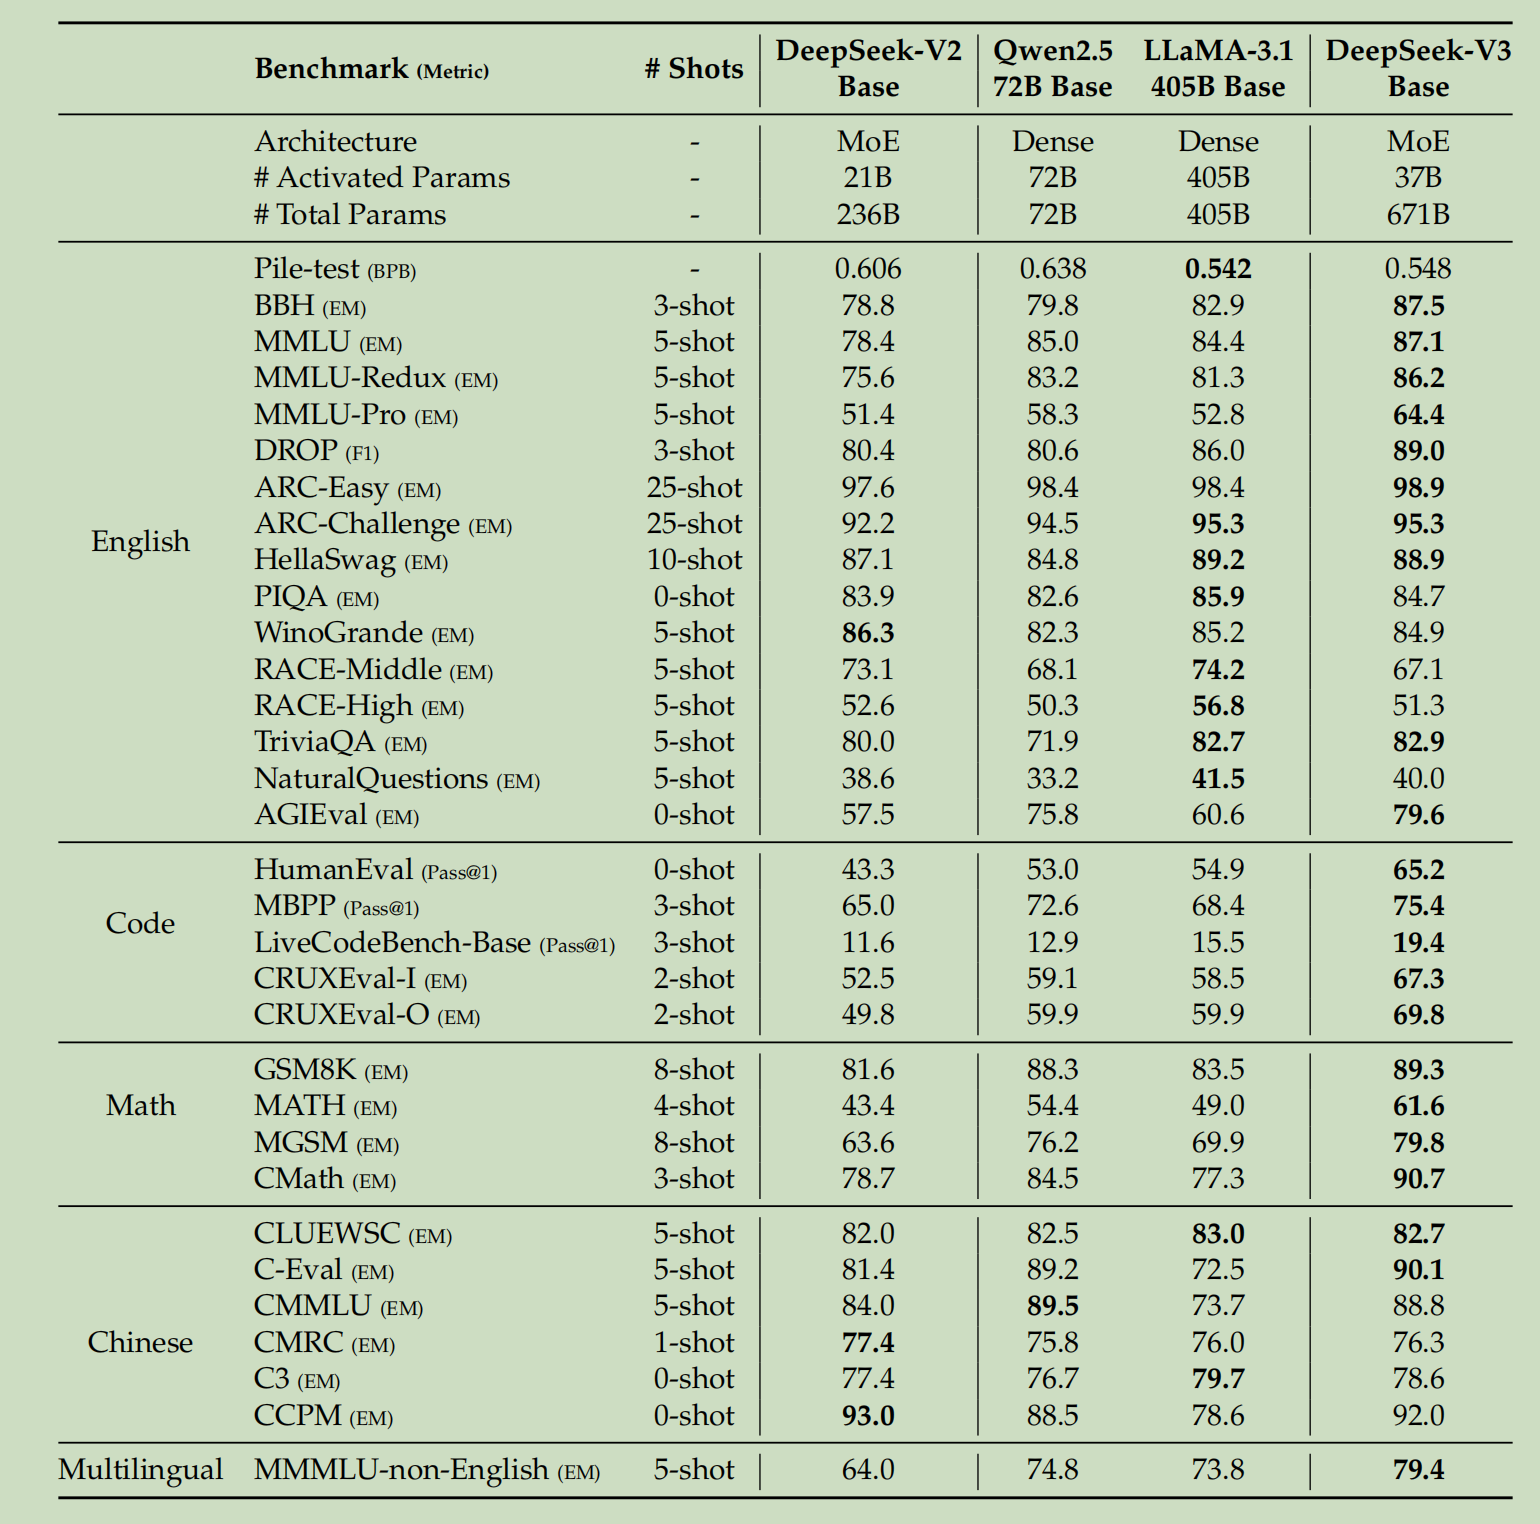
Benchmark
虽然 benchmark 不是全部,且被很多带着 KPI 来的开源、闭源模型搞得乌烟瘴气,但一定程度上也能说明点问题。