Deepseek R1
源码解析 Deepseek R1 增强学习算法 GRPO
启示
Deepseek 在模型算法创新和模型训练方面取得了显著成果,分别体现在两大核心产品上:Deepseek V3(模型算法,斜杠青年 DeepseekV3)和 Deepseek R1 (模型训练)上。其中,Deepseek R1 在增强学习领域的突破为我们提供了以下重要启示:
-
RLHF 并非必选项:通过创新的 RL 算法 GRPO(Generalized Reinforcement Policy Optimization),Deepseek R1 成功去除了高成本的 HF(Human Feedback)标注,在保证性能的同时显著降低了训练成本。实验表明,GRPO 在效果上优于传统的 RLHF 方法。
-
SFT 的优化与冷启动数据的重要性:Deepseek R1 采用了两阶段的 SFT(Supervised Fine-Tuning)策略,同时提升了冷启动数据的质量。这不仅提高了模型的初始性能,也为后续的强化学习奠定了更坚实的基础。
-
基础模型的关键作用:Deepseek R1 的完整版基于 Deepseek V3(采用 MOE 模型架构),而其他蒸馏版本则选用了 Qwen2.5 系列(传统 Dense 模型架构)作为基础模型。这一设计充分体现了基础模型对最终性能的决定性影响,同时也展现了 Deepseek 在模型架构选择上的灵活性与策略性。
增强学习
大语言模型的训练过程与人类教育学体系展现出惊人的相似性。虽然无法确切证明这是否是人类大脑生理结构或大语言模型神经元架构的最佳训练路径,甚至可能是一种局限,但它无疑是迄今为止最有效的实践方案之一。值得注意的是,人类大脑在能耗效率和收敛速度上远超现有大语言模型,但在横向扩展性上却远不及后者。
训练过程的类比与解析
-
基础知识的积累(Pretraining 阶段)
如同人类通过大量阅读、课堂学习和日常交流积累知识,大语言模型也通过海量数据的预训练来建立基础认知框架。 -
专项能力的提升(SFT 阶段)
类似于人类的课后作业、考试和资格认证,大语言模型通过监督微调(SFT)来优化特定任务的表现。 -
实践与反馈(RL 阶段)
正如人类在社会实践中需要快速应变和深度思考,大语言模型通过强化学习(RL)来提升综合能力,有时还会结合人类反馈(HF)—— 就像” 老板的怒火” 或” 社会的毒打”😄。
从这些特性来看,大语言模型或许已经触及了人类大脑结构的门槛,但也因此难以完全超越人类文明的局限。
Our goal is to explore the potential of LLMs to develop reasoning capabilities without any supervised data
Deepseek 的训练优化实践
起初,Deepseek 团队使用 GRPO RL 算法框架训练 Deepseek-V3-Base 模型,生成了 Deepseek-R1-Zero 模型。虽然其推理能力显著提升,但在可读性和多语言处理方面表现欠佳。
为此,团队调整了训练策略:
-
冷启动阶段
使用数千条高质量冷启动数据对 Deepseek-V3-Base 模型进行初步 SFT 训练。 -
增强学习阶段
采用与 Deepseek-R1-Zero 相同的 GRPO 增强算法对初步训练的模型进行强化学习,直至模型收敛。 -
微调数据生成
数据来源包括:- 利用第二步得到的 checkpoint 模型,采用拒绝采用策略(rejection sampling)生成高质量数据;
- 重用部分 Deepseek V3 的 SFT 数据。 利用上述得到的数据进行第二次 SFT 训练。
-
二次增强学习 再次采用相同的 GRPO 增强学习算法进行二次训练得到最终 Deepseek R1 模型。
GRPO 增强学习算法
上述是 Deepseek R1 的主体训练过程,下面来剖析其核心增强学习算法 — GRPO。
TRL 源码分析
在深入探讨 Deepseek R1 的核心增强学习算法 —— GRPO 之前,我们首先回顾了其主体训练过程。接下来,我们将从源码实现的角度,详细剖析 GRPO 算法的核心机制。
def trl_train_example():
	dataset = load_dataset("trl-lib/tldr", split="train")
	# 定义奖励函数
	def reward_len(completions, **kwargs):
		return [-abs(20 - len(completion)) for completion in completions]

	# num_generations
	training_args = GRPOConfig(output_dir="Qwen2-0.5B-GRPO", num_generations=8)

	trainer = GRPOTrainer(
		model="Qwen/Qwen2-0.5B-Instruct",
		reward_funcs=reward_len,
		args=training_args,
		train_dataset=dataset,
	)

	trainer.train()
其核心实现在 GRPOTrainer 中。
#  1. 继承自 trl 框架的核心抽象 Trainer
class GRPOTrainer(Trainer):
	def __init__(...):
		...

	def _get_eval_sampler(self, eval_dataset) -> Sampler:
		return RepeatRandomSampler(eval_dataset, self.num_generations, seed=self.args.seed)

	def _prepare_inputs(...):
		...

	def compute_loss(...):
		...
以上代码会在后续着重分析。
Trainer 框架
trl 框架的核心抽象 Trainer 采用了模板模式,这种设计模式允许我们通过定义算法的骨架,而将一些差异化的实现延迟到子类中。接下来,我们将逐步解析 Trainer 的核心训练流程。
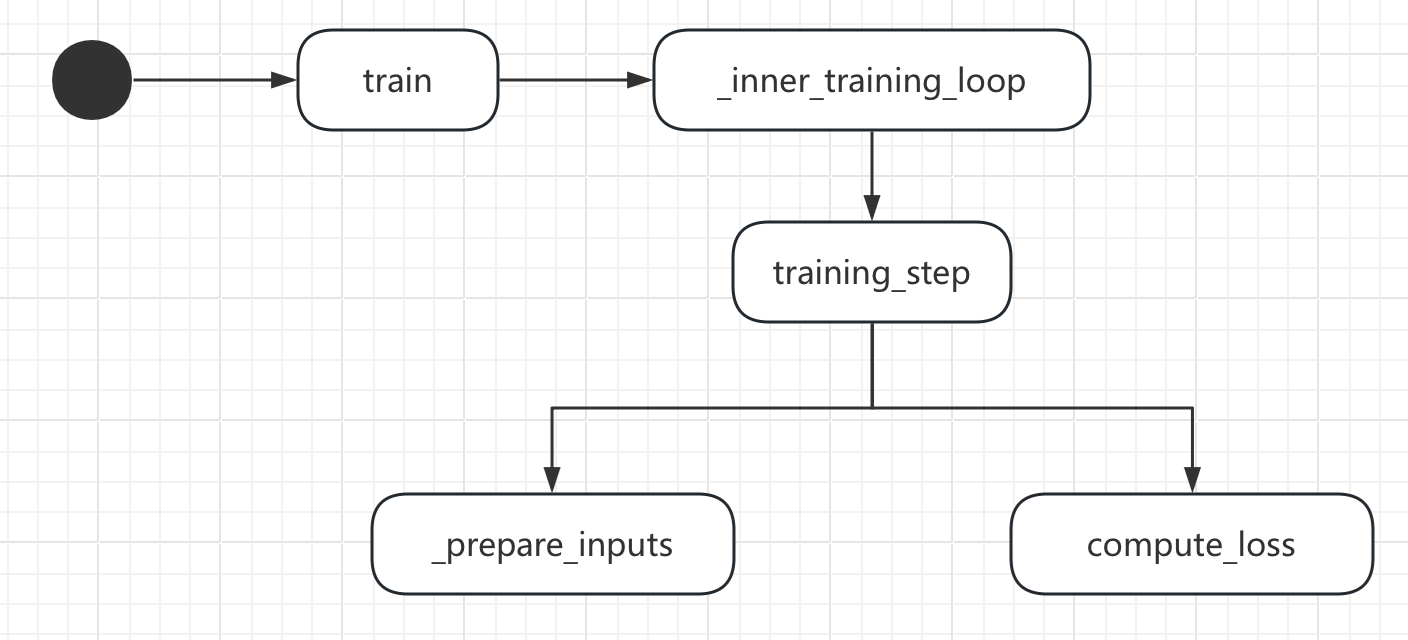
核心训练流程
Trainer 的训练流程可以通过以下函数调用链来概括:
-
train
处理继续训练(checkpoint)和模型发布相关事宜。 -
** _inner_training_loop ** 负责模型训练的周边细节准备,包括数据集加载、训练次数设定、批量大小配置、加速框架的选择、模型及奖励函数的初始化等。此外,该函数还负责对每批次样本进行训练(通过调用
training_step),并更新模型参数(通过optimizer.step())。 -
training_step
对每一个输入样本inputs进行训练,计算损失值。具体步骤包括:- 对
inputs进行预处理(_prepare_inputs)。 - 计算损失值(
compute_loss)。
- 对
-
_prepare_inputs 对输入数据进行预处理。Trainer 的默认实现较为简单,主要进行格式转换。
-
compute_loss
计算损失值。
GRPOTrainer 重写了 _prepare_inputs 和 compute_loss 方法,以实现 GRPO 算法的核心逻辑。
GRPO 算法数学表示
在深入代码之前,需要介绍 GRPO 算法的数学表示,以便与后续代码相互呼应。
GRPO 目标函数:
接下来,我们将重点关注 _prepare_inputs 和 compute_loss 方法。
Group 概念
GRPO 算法与传统 PPO 算法的一个重要区别在于,GRPO 会对同一个查询(query)进行多次(G 次)采样输出,对应公式 (1) 中的 ,即 GRPO 中的 G - Group。
该功能由 RepeatRandomSampler 类实现,并通过 num_generations 参数进行配置。使用 RepeatRandomSampler 在采样阶段复制出 num_generations 份 query 的好处在于,能够更有效地利用模型的批量(batch)处理能力。
class RepeatRandomSampler(Sampler):
	def __iter__(self):
		indexes = [
			idx
			for idx in torch.randperm(self.num_samples, generator=self.generator).tolist()
			for _ in range(self.repeat_count)
		]

		return iter(indexes)
_prepare_inputs 方法详解
def _prepare_inputs(self, inputs: dict[str, Union[torch.Tensor, Any]]):
	...
	# 1. 合理利用 vllm 加速推理的优点,虽然本案例没有配置使用。
	if self.args.use_vllm:
		...
	else:
		# Regular generation path
		with unwrap_model_for_generation(self.model, self.accelerator) as unwrapped_model:
			prompt_completion_ids = unwrapped_model.generate(prompt_ids, attention_mask=prompt_mask, generation_config=self.generation_config)

		# Compute prompt length and extract completion ids
		prompt_length = prompt_ids.size(1)
		prompt_ids = prompt_completion_ids[:, :prompt_length]
		completion_ids = prompt_completion_ids[:, prompt_length:]

	with torch.inference_mode():
		# 案例代码没有使用 perf 模型(LoRA),那么 ref_model 就是目标模型的一个深拷贝
		# 如果目标模型是 LoRA 模型,只要 disable_adapter 即可
		if self.ref_model is not None:
			ref_per_token_logps = self._get_per_token_logps(
				self.ref_model, prompt_completion_ids, attention_mask, logits_to_keep
			)
		...

	rewards_per_func = torch.zeros(len(prompts), len(self.reward_funcs), device=device)

	for i, (reward_func, reward_processing_class) in enumerate(
		zip(self.reward_funcs, self.reward_processing_classes)
	):
		if isinstance(reward_func, nn.Module):
			...
		else:
			# Repeat all input columns (but "prompt" and "completion") to match the number of generations
			keys = [key for key in inputs[0] if key not in ["prompt", "completion"]]
			reward_kwargs = {key: [example[key] for example in inputs] for key in keys}
			# 3.1 计算每个奖励函数,本例中只有一个 reward_len
			output_reward_func = reward_func(prompts=prompts, completions=completions, **reward_kwargs)
			rewards_per_func[:, i] = torch.tensor(output_reward_func, dtype=torch.float32, device=device)

	# Gather the reward per function: this part is crucial, because the rewards are normalized per group and the
	# completions may be distributed across processes
	rewards_per_func = gather(rewards_per_func)
	# Apply weights to each reward function's output and sum
	rewards = (rewards_per_func * self.reward_weights.to(device).unsqueeze(0)).sum(dim=1)

	# Compute grouped-wise rewards
	mean_grouped_rewards = rewards.view(-1, self.num_generations).mean(dim=1)
	std_grouped_rewards = rewards.view(-1, self.num_generations).std(dim=1)

	# 对奖励值做归一化,得到 advantages
	# Normalize the rewards to compute the advantages
	mean_grouped_rewards = mean_grouped_rewards.repeat_interleave(self.num_generations, dim=0)
	std_grouped_rewards = std_grouped_rewards.repeat_interleave(self.num_generations, dim=0)
	advantages = (rewards - mean_grouped_rewards) / (std_grouped_rewards + 1e-4)

	# Slice to keep only the local part of the data
	process_slice = slice(
		self.accelerator.process_index * len(prompts),
		(self.accelerator.process_index + 1) * len(prompts),
	)
	advantages = advantages[process_slice]

	return {
		"prompt_ids": prompt_ids,
		"prompt_mask": prompt_mask,
		"completion_ids": completion_ids,
		"completion_mask": completion_mask,
		"ref_per_token_logps": ref_per_token_logps,
		"advantages": advantages,
	}

# Get the per-token log probabilities for the completions for the model and the reference model
def _get_per_token_logps(self, model, input_ids, attention_mask, logits_to_keep):
	# We add 1 to `logits_to_keep` because the last logits of the sequence is later excluded
	logits = model(input_ids=input_ids, attention_mask=attention_mask, logits_to_keep=logits_to_keep + 1).logits
	logits = logits[:, :-1, :] # (B, L-1, V), exclude the last logit: it corresponds to the next token pred

	input_ids = input_ids[:, -logits_to_keep:]
	logits = logits[:, -logits_to_keep:]
	return selective_log_softmax(logits, input_ids) # compute logprobs for the input tokens
1. vLLM
在 GRPOTrainer 中,vLLM 被直接用作加速推理的优化点,这体现了 vLLM 在模型推理开源框架中的重要地位。尽管在案例代码中并未使用 vLLM,但其在性能优化方面的潜力不容忽视。
2. Reference Model
在论文中,需要训练的模型被称为目标模型(即 policy model)。Reference Model 作为目标模型的参考,通常与目标模型同属一个模型,且初始化时模型参数一致。为了不影响目标模型的参数更新,Reference Model 一般独立运行。代码实现中有三种选择:
- 如果使用 vLLM,则让 vLLM 重新加载目标模型实例。
- 如果使用 Perf Model(如 LoRA),则 Reference Model 和目标模型共用一个模型实例,通过
disable_adapter来切换使用。 - 如果上述两种情况都不适用,如本例配置,则深拷贝一个目标模型作为 Reference Model。
通过计算目标模型相对于 Reference Model 的 KL 散度,可以影响目标模型参数的梯度更新。
3. 奖励函数
计算每个奖励函数,并对奖励值做归一化,即实现公式 (3):
4. Log Probabilities
计算模型针对输入 query 的生成对应输出 的概率,,为后续计算公式(2) KL 散度做准备。
compute_loss 方法详解
def compute_loss(self, model, inputs, ...):
	...
	# 计算目标 model 的 logps
	per_token_logps = self._get_per_token_logps(model, input_ids, attention_mask, logits_to_keep)
	# _prepare_inputs 中 reference model 的 logps
	ref_per_token_logps = inputs["ref_per_token_logps"]
	# 1. 计算 KL 散度,即公式(2)
	per_token_kl = torch.exp(ref_per_token_logps - per_token_logps) - (ref_per_token_logps - per_token_logps) - 1

	# 2. 目标函数计算,即公式(1)
	# x - x.detach() allows for preserving gradients from x
	advantages = inputs["advantages"]
	per_token_loss = torch.exp(per_token_logps - per_token_logps.detach()) * advantages.unsqueeze(1)
	per_token_loss = -(per_token_loss - self.beta * per_token_kl)
	loss = ((per_token_loss * completion_mask).sum(dim=1) / completion_mask.sum(dim=1)).mean()
compute_loss 中的主要参数 inputs,其实就是 _prepare_inputs 的返回值。
1. KL 散度
KL 散度用于衡量两个概率分布之间的差异。具体计算公式(即公式 (2))如下:
其中,
_prepare_inputs 中计算 reference 模型的 ,此处再计算得到目标模型的 ,便可计算 KL 散度(如代码所示)。
KL 散度越小,说明目标模型与参考模型的分布越接近。
2. 目标函数计算
最终完成目标函数计算。这里我们会发现,代码实现与实际公式 (1) 存在较大出路,缺少了 计算和 clip 过程。这是因为 trl 的 release 版本基于 的假设,做了简版实现。公式 (1) 转变为:
trl 的 main 分支上有完整版本的实现,可做进一步的参考。
SFTTrainer 数据格式
data_collator = torch_default_data_collator -> torch_default_data_collator 对多个原数据格式数据重新调整组织成批(batch)。
data_collator 最终和 dataset 一起汇入 DataLoader,其作为参数 collate_fn
collate_fn (Callable, optional): merges a list of samples to form a mini-batch of Tensor(s). Used when using batched loading from a map-style dataset.