大语言模型基础(一)——Transformer
数学是机器学习(人工智能)的基础,以算法的形式投射到计算机,这个 20 世纪最重要的发明之上。深度学习作为一种很 “深” 的神经网络算法,是机器学习的一个分支,虽然该算法起源于上世纪 40 年代,但伴随着计算加速器 GPU 的兴起,已成为现今炙手可热的研究领域,技术日新月异,逐步渗透到人类生活的方方面面。
而大语言模型,狭义而言,基于 Transformer 模型架构的深度学习算法,更是占据了近两年的榜首,至今无所出其右。
如果按生物学,界、门、纲、目、科、属、种分类形式,不去纠结亚科、亚属、亚种等亚系分类,那么现今流行的大语言模型 ChatGPT 、Claude、Llama 等即使不是同种,也肯定是同属,decoder-only 属,归属于 Transformer 科。CNN 、RNN、 Transformer 是神经网络目下的三个科。而 Llama、Mistral 、 Gemma 无疑是在不同环境下的同种模型。
因此将范围限定,当我们讨论大语言模型时,我们讨论的是 Transformer 下 decoder-only 模型架构。
深度学习基础中介绍了一个不 “深” 的神经网络,以及相关的代码实现。本节我们首先来介绍大语言模型鼻祖,Transformer 模型架构。
Transformer
Transformer 模型结构如下图所示,图片来自 Google 的论文《Attention Is All Your Need》,额外标注了 Encoder 和 Decoder。
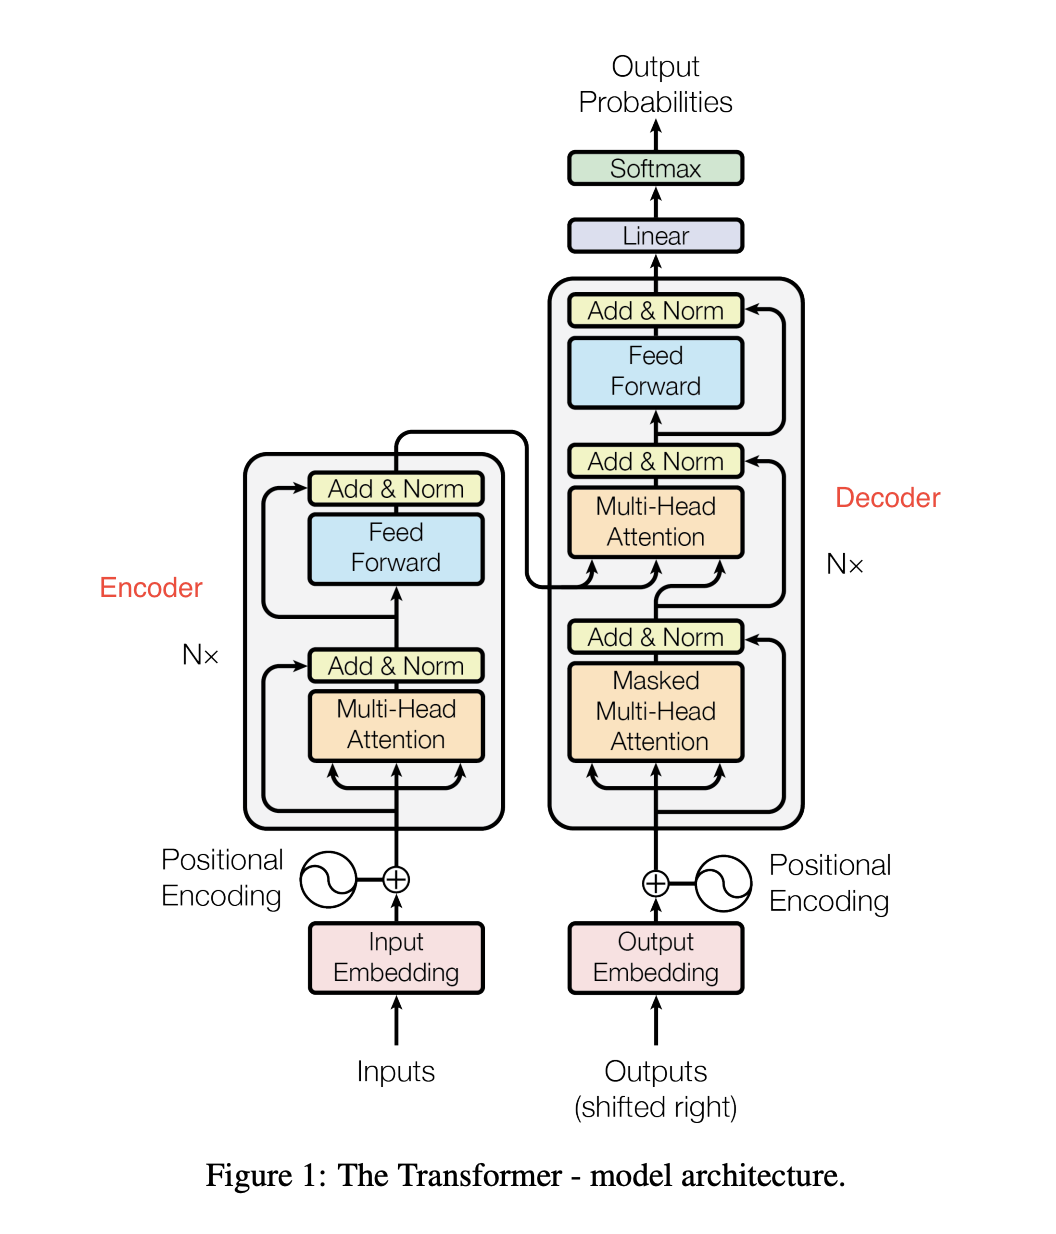
图中包含了大语言模型所用到的基本模型组件,除了广泛应用于 NLP 领域中用于文本处理的 Tokenizer 最近。Tokenizer 的作用是将语言文本转化成图中的 Inputs 和 Outputs,后续会有单独一节来独立介绍 Tokenizer,这里不过多涉及。
惯例,上代码,Pytorch 中 Transformer 的实现,只保留部分核心代码。
class Transformer(Module):
	def __init__(self, d_model: int = 512, nhead: int = 8, num_encoder_layers: int = 6, num_decoder_layers: int = 6, dim_feedforward: int = 2048, dropout: float = 0.1, activation: Union[str, Callable[[Tensor], Tensor]] = F.relu, ...) -> None:
		...
		# encoder 初始化
		encoder_layer = TransformerEncoderLayer(d_model, nhead, dim_feedforward, dropout, activation, layer_norm_eps, batch_first, norm_first, bias, **factory_kwargs)
		encoder_norm = LayerNorm(d_model, eps=layer_norm_eps, bias=bias, **factory_kwargs)
		self.encoder = TransformerEncoder(encoder_layer, num_encoder_layers, encoder_norm)
	    # decoder 初始化
		decoder_layer = TransformerDecoderLayer(d_model, nhead, dim_feedforward, dropout, activation, layer_norm_eps, batch_first, norm_first, bias, **factory_kwargs)
		decoder_norm = LayerNorm(d_model, eps=layer_norm_eps, bias=bias, **factory_kwargs)
		self.decoder = TransformerDecoder(decoder_layer, num_decoder_layers, decoder_norm)

class TransformerEncoder(Module):
	def __init__(self, encoder_layer, num_layers, norm=None, enable_nested_tensor=True, mask_check=True):
		self.layers = ModuleList([copy.deepcopy(encoder_layer) for i in range(num_layers)])

class TransformerDecoder(Module):
	def __init__(self, decoder_layer, num_layers, norm=None):
		self.layers = ModuleList([copy.deepcopy(decoder_layer) for i in range(num_layers)])

class TransformerDecoderLayer(Module):
	def __init__(self, ...) -> None:
		self.self_attn = MultiheadAttention(d_model, nhead, dropout=dropout, batch_first=batch_first, bias=bias, **factory_kwargs)
		self.multihead_attn = MultiheadAttention(d_model, nhead, dropout=dropout, batch_first=batch_first, bias=bias, **factory_kwargs)
		# Implementation of Feedforward model
		self.linear1 = Linear(d_model, dim_feedforward, bias=bias, **factory_kwargs)
		self.dropout = Dropout(dropout)
		self.linear2 = Linear(dim_feedforward, d_model, bias=bias, **factory_kwargs)

		self.norm_first = norm_first
		self.norm1 = LayerNorm(d_model, eps=layer_norm_eps, bias=bias, **factory_kwargs)
		self.norm2 = LayerNorm(d_model, eps=layer_norm_eps, bias=bias, **factory_kwargs)
		self.norm3 = LayerNorm(d_model, eps=layer_norm_eps, bias=bias, **factory_kwargs)
		self.dropout1 = Dropout(dropout)
		self.dropout2 = Dropout(dropout)
		self.dropout3 = Dropout(dropout)

	def forword(self, ...):
		x = tgt
		if self.norm_first:
		    x = x + self._sa_block(self.norm1(x), tgt_mask, tgt_key_padding_mask, tgt_is_causal)
		    x = x + self._mha_block(self.norm2(x), memory, memory_mask, memory_key_padding_mask, memory_is_causal)
		    x = x + self._ff_block(self.norm3(x))
		else:
		    x = self.norm1(x + self._sa_block(x, tgt_mask, tgt_key_padding_mask, tgt_is_causal))
		    x = self.norm2(x + self._mha_block(x, memory, memory_mask, memory_key_padding_mask, memory_is_causal))
		    x = self.norm3(x + self._ff_block(x))
	# self-attention block
	def _sa_block(self, x: Tensor,
	              attn_mask: Optional[Tensor], key_padding_mask: Optional[Tensor], is_causal: bool = False) -> Tensor:
	    x = self.self_attn(x, x, x,
	                       attn_mask=attn_mask,
	                       key_padding_mask=key_padding_mask,
	                       is_causal=is_causal,
	                       need_weights=False)[0]
	    return self.dropout1(x)

	# multihead attention block
	def _mha_block(self, x: Tensor, mem: Tensor,
	               attn_mask: Optional[Tensor], key_padding_mask: Optional[Tensor], is_causal: bool = False) -> Tensor:
	    x = self.multihead_attn(x, mem, mem,
	                            attn_mask=attn_mask,
	                            key_padding_mask=key_padding_mask,
	                            is_causal=is_causal,
	                            need_weights=False)[0]
	    return self.dropout2(x)

	# feed forward block
	def _ff_block(self, x: Tensor) -> Tensor:
	    x = self.linear2(self.dropout(self.activation(self.linear1(x))))
	    return self.dropout3(x)
代码简洁且直接,看懂上图,基本就能对号入座。需要注意以下几点:
1. 没有包含 Embedding
Transformer 类中没有包括 Embedding 组件,与 Pytorch 中现行主流大模型,比如 Llama,的实现有所不同。
LlamaModel 的实现包含了 Embedding 组件,因此模型的 forward 方法中传入的是经过 tokenize,但未被 embedding 的 input_ids。而 Transformer 实现中 forward 方法入参 src 和 tgt 都需要预先 embedding。
Embedding 简单来说就是将字符串 tokenize 后的 tokens(float 表示),每个 token 映射成一个一维向量。这个向量会在模型训练时进行学习,最终用于模型推理。
2. 重点关注 TransformerEncoderLayer
代码和图示一一对应,Transformer 的主体由 TransformerEncoderLayer 和 TransformerDecoderLayer 重复 N 次连接而成。这里的重复是 deepcopy,意味着每个 TransformerEncoderLayer 或 TransformerDecoderLayer 是独立的,只是结构相同而已。
从图中可以看到,TransformerDecoderLayer 和 TransformerEncoderLayer 本身的结构也类似。TransformerDecoderLayer 相比 TransformerEncoderLayer 而言,多了一个 Masked Multi-head Attention,再者现今主流的大模型都是用 decoder-only Transformer 架构,因此此处我们重点关注 TransformerEncoderLayer。
TransformerDecoderLayer 代码实现没有对图示组件进一步封装,特别是 Feed Forward。而是在 forward 方法中,通过不同函数定义进行区分。每个人对抽象层级有自己的看法,这里就不过多纠结。
代码中特意把 norm_first 保留了下来,它用于区分信息在神经网络中传递(计算)时,是对入参做 norm 还是对结果做 norm,这就有了 pre norm 和 post norm 之分,公式如下: PreNorm: PostNorm: 如图,显然原始文章中的 Transformer 架构是 post norm,但这里的代码实现是可供选择的。而 Llama 明确使用的是 pre norm。
另外,还有个陌生的 Dropout 组件。它的作用是将入参向量随机的丢弃部分值(置 0),为了防止模型与训练数据过拟合,一般在训练阶段使用。此处的 Transformer 代码中没有区分训练和推理,在其他模型实现中,比如 Llama,会对此做区分。
无论是不同的 norm 时机,还是 Dropout 组件,它们的由来犹如 ChatGPT 一般,至今无法科学解释。到底是 pre norm 易于训练,还是 post norm 效果更好,都是反复实验的结果,然后再 “马后炮” 式的去找理论依据。
对 Transformer 的介绍就到此为止,想要进一步的了解,最好的方式是看论文《Attention Is All You Need》。论文需要太多上下文,不知如何入手?李沐在哔哩哔哩的教学视频,强烈推荐!