模型泛化能力提升:正则化技术的理论与实现
正则化 & 损失函数
正则化是一种在模型训练过程中加入损失函数的技术,旨在减少模型的过拟合现象。它同样适用于深度学习模型,帮助提高模型的泛化能力。
当前,主要存在两种流行的正则化技术:L1 正则化和 L2 正则化,公式如下:
L1 正则化
L2 正则化(权重衰减)
其中, 是原始的损失函数, 是正则化后的损失函数。
梯度下降
模型训练的核心目标是寻找参数 w 的最优值,以使得损失函数 L 最小化。梯度下降算法是当前广泛采用的参数优化方法(另一种是直接解方程,给出解析解,适合小数据量),尤其在深度学习领域,它构成了模型参数学习的基础。简而言之,梯度下降算法是深度学习中模型参数优化的核心。
梯度下降的基本思想:首先对参数 在损失函数 上求导 ,获得参数符合测试数据集的最近方向,即梯度;然后选取特定的学习率 对参数进行更新 ,即下降。
L1 正则化展开
损失函数求导,并展开:
得
其中 sgn (w) 是符号函数,
可知,L1 正则化后的损失函数 是在原有的损失函数 之上增加了防止过拟合的惩罚项 。且其中 都是正数,当 w <0 时,惩罚项为负,w 变大;当 w> 0,w 变小;w 都是往 0 的方向靠拢。
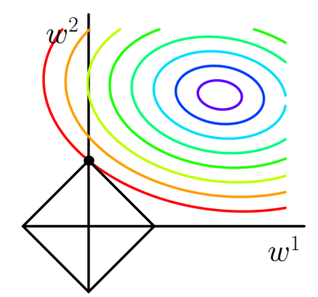
查看原损失函数 和 L1 - 正则化(范数)的等高线,能够更加直观的看到 w 更容易为零。易得到稀疏矩阵,适合做特征删选,同时也防止过拟合(很多变量权重为 0)。
L2 正则化展开
同理,L2 损失函数求导:
得
公式表明,对参数 w 做了一定比例 缩放后,再去更新参数。也就是说,在最终参数方向收敛的情况下绝对值 在变小。权重衰减(weight decay)也因此得名。
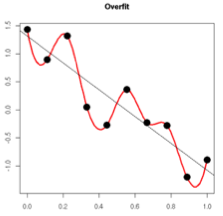
那么它是如何做到防止过拟合的?一种解释过拟合的模型参数往往比较大,因为它们变化剧烈,因此其导数比较大。导数跟变量本身的大小无关,但和其系数(即参数 w)有关。因此参数 w 越小,拟合度也就越小。
再来看 L2 正则化(范数)与原损失函数的等高线图:
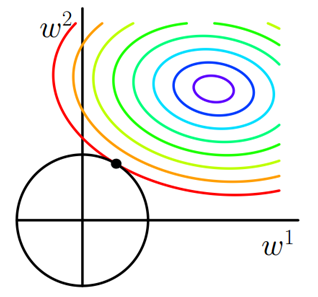
可知,两者的交点不可能会出现在数轴上,因此 w 不会为 0。
线性回归
线性回归的公式如下
使用最小二乘法的损失函数
lasso 回归
Lasso 回归的模型没有变,仍然是线性回归模型,但是损失函数增加了 L1 正规化。
Ridge(岭)回归
同理,岭回归在线性模型基础上,损失函数使用了 L2 正规化
AdamW
深度学习优化算法 AdamW 就是在 Adam 基础上加了 weight decay,即 L2 正则化。
作为深度学习(神经网络)模型骨架结构的多层感知机分解下来的主要成分,其实就是线性回归。那么 AdamW 也是自然而然的一件事了。
既然到了线性回归,除了参数 w 外还有一个偏置参数 b。对偏置求导
得
因此 L2 正则化不会对偏置 b 参数产生影响。
代码实现
L2 正则化 Pytorch 实现版本(来自动手学深度学习)
# 定义了 SGD 中用到的 batch_size
train_iter = load_array(train_data, batch_size)

def train(lambd):
    w, b = init_params()
    net, loss = lambda X: linreg(X, w, b), squared_loss
    num_epochs, lr = 100, 0.003
    for epoch in range(num_epochs):
        for X, y in train_iter:
            # 增加了L2范数惩罚项(原教程代码)
            l = loss(net(X), y) + lambd * l2_penalty(w)
            # batch_size 直接体现在损失函数,与 L2 正则化中除以训练案例数 n 匹配上。
            # 原教程代码将 batch_size 放到了 sgd 优化函数中。
            # 这里就需要注意 lambd 参数的选择了,需要扩大到 batch_size 倍
            # l = loss(net(X), y) + lambd * l2_penalty(w) / batch_size
            l.sum().backward()
            sgd([w, b], lr, batch_size)

def l2_penalty(w):
    return torch.sum(w.pow(2)) / 2

def sgd(params, lr, batch_size):
    """小批量随机梯度下降"""
    with torch.no_grad():
        for param in params:
            param -= lr * param.grad / batch_size
            # batch_size 移到损失函数
	        # param -= lr * param.grad
            param.grad.zero_()

def linreg(X, w, b):
    """线性回归模型"""
    return torch.matmul(X, w) + b

def squared_loss(y_hat, y):
    """均方损失"""
    return (y_hat - troch.reshape(y, y_hat.shape)) ** 2 / 2
这里需要注意的是,原教程代码中没有完全遵循开篇 L2 正则化后的损失函数公式,少了训练案例数 n。包括后面会马上涉及的简洁版本实现中,L2 正则化(weight decay)也是放在优化算法 AdamW 中。
L2 正则化 Pytorch 简洁版本,在原教程代码基础上,将 SGD 优化算法改成 AdamW。
def train_concise(wd):
    net = nn.Sequential(nn.Linear(num_inputs, 1))
    for param in net.parameters():
        param.data.normal_()
    loss = nn.MSELoss(reduction='none')
    num_epochs, lr = 100, 0.003
    # 偏置参数没有衰减
    # trainer = traineroptim.SGD([
    #    {"params":net[0].weight,'weight_decay': wd},
    #    {"params":net[0].bias}], lr=lr)
	trainer = torch.AdamW(net[0].weight, lr=lr, weight_decay=wd)
    for epoch in range(num_epochs):
        for X, y in train_iter:
            trainer.zero_grad()
            l = loss(net(X), y)
            l.mean().backward()
            trainer.step()