大语言模型基础(二)-- Attention 续
注意力机制
注意力类似思想可以追溯到 1964 年的 Nadaraya-Watson 核回归,公式如下:
其中 K 是核函数。
公式表达的意义直接明了,就是要找到一个核函数 K。给定输入 x,计算 x 与已知输入数据(xi)间的距离(x - xi)的核函数,并作为不同已知输出数据(yi)的权重求和,得到对应的输出 y。
Nadaraya-Watson 核回归本身比较符合直觉,易于理解。通过特征(x)距离作为权重,对输出(y)做预测,完全能够接受。那么就剩下核函数 K,它又有什么奇妙的地方呢?
核函数
核函数是支持向量机(SVM)机器学习算法的核心。支持向量机的基本原理简单来说,就是基于目标数据高维可分的假设,来寻求一个能够对数据进行高维分割的超平面,从而达到分类的目的。而核函数的使用能够减少数据升维计算带来的复杂度,通过相对简单的核函数计算就能够达到数据向量升维、求内积的效果。
常用的核函数有:
高斯核,
Sigmoid 核(tanh 是一类 sigmoid 核函数),
至于将核函数应用于 Nadaraya-Watson 核回归有什么理论依据?我想和大部分机器学习算法类似,更多的是一种技巧和手段,通过不断尝试来验证效果。Nadaraya-Watson 核回归总体上还是非常符合直觉的。特别是到了神经网络,深度学习算法,其中用到的各种数学工具的可解释性就更差了。
确定性
寻求理论依据和可解释性的本质是对 “确定性” 的追求。“确定性” 意味着安全,意味着普世,意味着某种终极。
这种确定性,在物理科学中已经被量子力学所打破。而大语言模型的研究也逐渐偏向于 “艺术” 的范畴。在早前一篇文章,Chatgpt 下程序员该如何自处中有对技术的 “艺术” 性和 “科学” 性有所讨论。
如同一个厨师需要不断尝试,食材、配菜、调料、厨具、火候,也只能制造出一个菜式或一类美味一般。我们在大语言模型学习中接触的模型架构,其使用的算法、组件,很大部分都是对已有机器学习方法、技巧的重新拼凑,用实验结果来检验其有效性,再回过头来寻求理论依据的过程。
注意力汇聚函数
注意力机制中,x 作为自主性提示 Query,xi 是非自主性提示 Key,yi 对应值 Value,代入并简化 Nadaraya-Watson 核回归公式,同时使用高斯核得到:
其中,
上述公式就是非参数注意力汇聚模型(non-parametric attention pooling)。这里的非参数不是指没有参数,而是指没有深度学习中需要训练学习得来的参数。
顾名思义,带参数注意力汇聚模型就是在非参数注意力汇聚模型上加一个参数 w:
softmax
经过一系列变换,从 Nadaraya-Watson 核回归转移到了 softmax 函数。
Softmax 函数在机器学习中主要用于多分类问题,它将一个任意实数向量转换为概率分布。它的作用是将神经网络输出的原始分数(也称为 logits)转换为表示每个类别的概率值,这些概率值加起来等于 1。
那么,注意力汇聚模型可解释为,Value yi 在 Query x 和 Key xi 之间距离(x - xi)转化后的加权平均。
注意力评分函数
进一步将注意力机制中的 Q、K 、V 代入公式,
,其中 就是注意力评分函数。
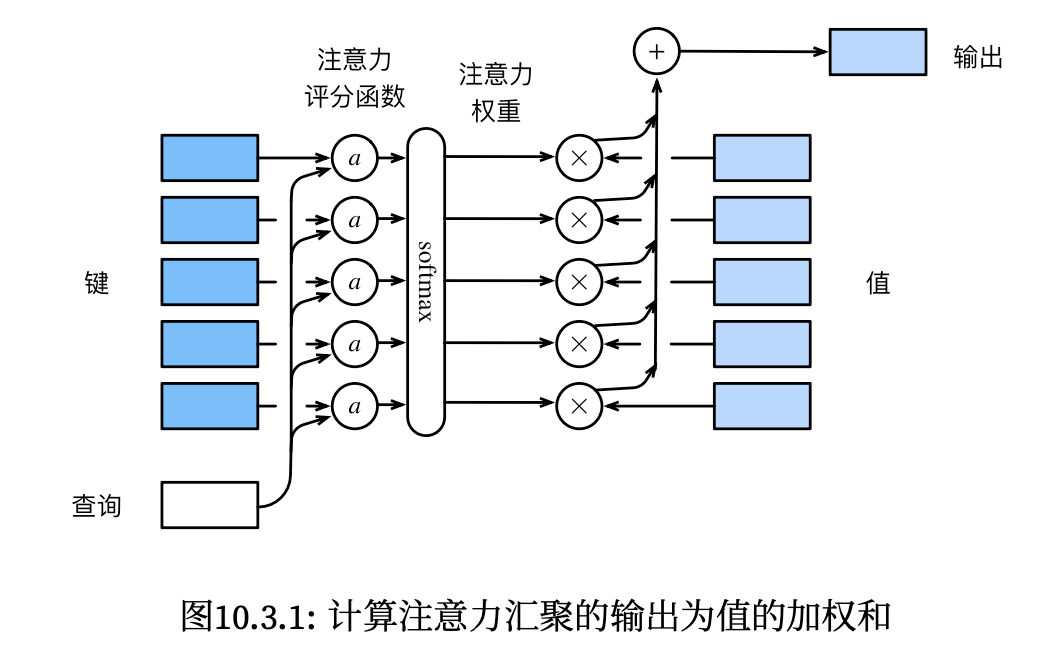
上图形象的解释了公式的计算过程。
自注意力
有了自注意力评分函数的概念后,自然而然能够联想到,有没有其他评分函数来替换 ,能够达到更好的效果?
于是有了加性注意力(additive attention)和缩放点积注意力(scaled dot‐product attention),
加性注意力,
缩放点积注意力,,其中 d 是向量 q /v 长度。
显然加性注意力比缩放点积注意力需要学习的参数 W 更多。
缩放点积注意力因其计算效率高和可扩展性好,并且它在处理长序列时特别有效,因而被广泛应用于 Transformer 模型中。
而自注意力(self-attention)的 self 是指 q /k/v 本是一体。对于大语言模型而言是,它们是同一段字符串进行 tokenize、embedding 处理后的三个分身。
以 huggingFace transformers 模块中 LlamaAttention 的实现为例:
class LlamaAttention(nn.Module):
	def __init__(self, config: LlamaConfig, layer_idx: Optional[int] = None):
		...
		# 以下是对需要学习的参数 W 的定义
		self.q_proj = nn.Linear(self.hidden_size, self.num_heads * self.head_dim, bias=config.attention_bias)
		self.k_proj = nn.Linear(self.hidden_size, self.num_key_value_heads * self.head_dim, bias=config.attention_bias)
		self.v_proj = nn.Linear(self.hidden_size, self.num_key_value_heads * self.head_dim, bias=config.attention_bias)
		# self.o_proj = nn.Linear(self.hidden_size, self.hidden_size, bias=config.attention_bias)
		...

	def forward(...):
		# q / k / v 出自同个 hidden_states
		query_states = self.q_proj(hidden_states)
		key_states = self.k_proj(hidden_states)
		value_states = self.v_proj(hidden_states)
		...
		attn_weights = torch.matmul(query_states, key_states.transpose(2, 3)) / math.sqrt(self.head_dim)
		attn_weights = nn.functional.softmax(attn_weights, dim=-1, dtype=torch.float32).to(query_states.dtype)
		# attn_weights = nn.functional.dropout(attn_weights, p=self.attention_dropout, training=self.training)
		attn_output = torch.matmul(attn_weights, value_states)
		# attn_output = self.o_proj(attn_output)
以上代码只截取了自注意力机制的核心逻辑实现,即对上述注意力公式的代码实现。
另外,有部分对 Transformer 性能具有重要影响的算法没有在此处体现。其中包括,旋转式位置编码(rotary embedding)、多头注意力(multi-head attention),争取在后续算法部分补充完整。
总结
大语言模型 Attention 部分,我们从生物注意力(当下有大量基于注意力经济的应用)这个生理学现象入手,解释了机器学习专家们如何将注意力机制抽象为 query 、key 和 value。
将抽象 query 、 key 、 value 落地成算法,可以追溯到 Nadaraya‐Waston 核回归思想。当 Nadaraya‐Waston 采用高斯核后,公式就转换到 softmax 函数。
进一步抽象出注意力评分函数。通过尝试不同的注意力评分函数,得到了加性注意力和缩放点积注意力。缩放点积注意力在计算效率、可扩展性以及处理长序列方面的优势,被 Transformer 广泛采用。
对于 NLP 而言,训练数据就是大量人类已有的语料。因此,当 query 、 key 、 value 使用同一段字符串文本时,就是自注意力机制了。
当然,本文涉及的只是自注意力机制算法的主体部分,还有很多算法技巧没有覆盖到,比如旋转式位置编码(rotary embedding)和多头注意力(multi-head attention),争取在后续算法部分补充完整。
后记
距离 大语言模型基础(一) — Transformer 快有 1 个月了,计划中的大语言模型基础第二部分迟迟无法孕育。尤似在贫瘠的土地上,拼命浇水、除草,却没有种子破土而出的迹象。
心里不着急是不可能的,甚至有些焦躁。给自己 2~3 周的,确是过于乐观了。