Llama 3
Introducing Meta Llama 3: The most capable openly available LLM to date, Meta 官网
Llama 3 发布已经 2 周了,我们来回顾一下 Meta 发布在官网的介绍文章。
模型结构
4 月 16 日当天发布的 Llama 3 只包含了 8B 和 70B 版本,400B 版本还在训练中,30B 级别的模型不见了。
In line with our design philosophy, we opted for a relatively standard decoder-only transformer architecture in Llama 3. Compared to Llama 2, we made several key improvements. Llama 3 uses a tokenizer with a vocabulary of 128K tokens that encodes language much more efficiently, which leads to substantially improved model performance. To improve the inference efficiency of Llama 3 models, we’ve adopted grouped query attention (GQA) across both the 8B and 70B sizes. We trained the models on sequences of 8,192 tokens, using a mask to ensure self-attention does not cross document boundaries.
Llama 3 在模型结构方面基本和 Llama 2 保持一致,对以下几方面做了改进:
- 采用了新的 tokenizer,词汇量从 llama 2 的 32k 增加到现在的 128K。并且从 Google 的 sentencepiece,转到使用 OpenAI 的 tiktoken。
- 模型训练序列长度,也从 4k 增长到 8k。训练序列长度是 8k,并不意味着 Llama 3 只能支持 8k 上下文。还有很多技术手段能够扩展输入 prompt 长度,而不改变模型性能。最近身处风口浪尖的国内 AI 创业公司月之暗面的看家本领,就是无损长文本能力。
- Llama 3 全系采用 GQA。
模型性能
受限于手头的硬件条件,只能通过使用 Llama 3 的 8B 版本来谈一下个人的主观感受。(声明:以下结论没有经过严谨的对比实验,仅是本人结合自身的使用经验得出的主观评价。)
Llama3 8B 版本在同级别(7~15B)模型中毫无疑问是最强的,也是幻觉输出最少的。实际使用下来,它的性能甚至不比高一级别的模型差,包括 Mistral-22B、Qwen1.5-32B 等。
在代码能力方面,更是让人惊喜!这次选择的实验对象是开源项目 ChatDev,一个多角色开发 Agents 框架。通过修改 ChatDev 部分源代码,使其具备访问本地 LLM 模型的能力。
据此,对比了部分风评不错,且能在我的 MacBook Pro M1 32G 上能跑的开源模型,包括 Qwen1.5-32B 、WizardCoder-32B、 Mistral-22B、WizardLM2-7B 和 Llama3-8B。使用了以下开发目标:
Minesweeper game in pure html
令人意外的是,只有 Llama3-8B 产生了能跑的中间结果代码,即使最后产生了幻觉。而其他模型,虽然有部分也产生了中间代码,但都不符合要求。
本地模型到最后都产生了幻觉,但是闭源模型 ChatGPT4 和 ChatGLM4 通过了测试,结果正确且都没有产生幻觉。结合 ChatGLM4 平时的使用经验,迄今,国内模型我首推 ChatGLM4。
如果大家有兴趣,后续写一个搭建 ChatDev 使用本地 LLM 模型的教程。
模型安全的系统化方法
在 “A system-level approach to responsibility” 一节,频繁使用了 Response 这个词,一开始让人很是摸不着头脑。稍深入查阅才发现 Response 和 Alignment 差不多一个意思,责任也好,对齐也罢,我把它们统一成为模型安全。
显然,Meta 不会只是哗众取宠的创造一个新的词汇 responsibility 来代替原有的 alignment,也有它系统化的一面。
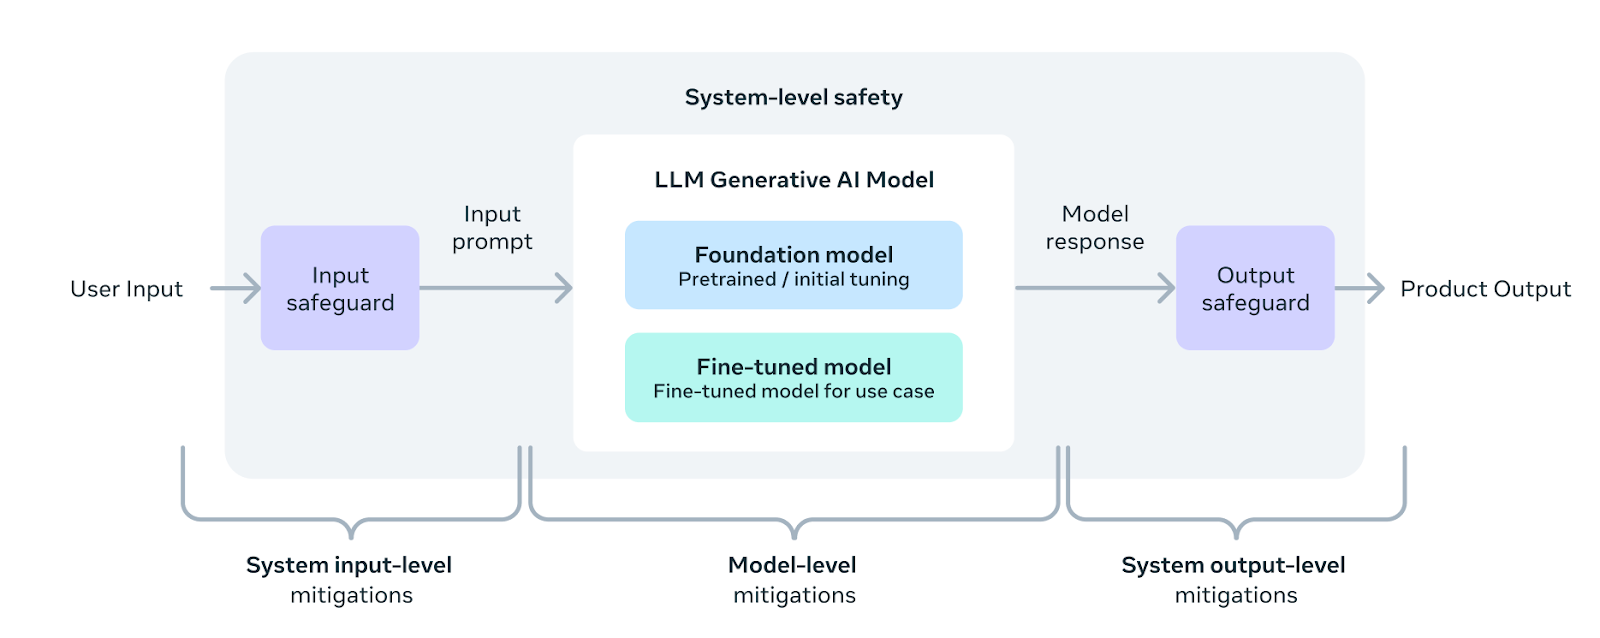
首先是模型级别安全方法,类似 alignment 的过程,在指令微调时期保证模型安全。采用专家和自动化想结合的 red teaming 方法,期间应用了很多通用安全思想。对应图中间的 model-level mitigations。
其次是系统级别安全,又可以分为 3 个层级对应 3 个安全产品。Llama Guard 2,在微调过程中保证 prompt 和输出时期的安全(HuggingFace 上提供了 Llama Guard 版本的模型);CyberSecEval 2,防止模型提供的代码编译器等能力的滥用;Responsibility User Guider,是对模型之上的应用生态的一种安全指导方案。
Meta 提出的这种系统化的安全方法以及落地方案,很具有借鉴意义。区分了模型、系统、应用 3 个级别,并有落地的安全方法、产品和指导方案。
经过近两周网络上对 Llama 3 8B 和 70B 大量使用和测评来看,几个月后的 400B+ 版本还很可能超过 ChatGPT4 和 Claude3,大家拭目以待。
有了又能如何?为硬件发愁啊。