温故知新——Tokenizer技术BPE算法详解
如今无论你以何种方式接触这个世界 — 看到的、听到的或者触摸到的 — 都自觉或不自觉地与文字实体相关联。我们已经很难想象在文字出现之前,人类是如何理解这个世界的。
文字是人类理解世界的桥梁,而 token 则是大模型理解世界的媒介。
我们将从缺乏实验依据的经验性认知世界的方式谈起,介绍当前大模型普遍采用的 tokenizer 算法 BPE(Byte Pair Encoding),阐述其代码实现,并对比不同语言在不同工程实现间的性能差异。
如何认知世界?
抽象是人类高效认知世界的关键手段,语言便是这一高效手段的产物,使人们能够从高熵世界中抽取出低熵信息。
大语言模型作为一种人工智能,其认知方式受限于人类,同样采用文字来理解世界。
人类与现有硅基 AI 的主要劣势在于:人类只能能够处理多模态信息(受限于感官,如眼睛、耳朵,暂不考虑触觉、嗅觉等)。而这类多模态信息难以被高效抽取。对现代人而言,这些信息常常会不自觉地被转化为自然语言信息。即便是阅读文字,同样需要做这层转换。因此无论是在低熵信息接受速度,还是多余的转换过程,都不及硅基 AI。当然在感受世界(爱与美)的方面,还是 AI 所不具备的。
相较于硅基 AI,人类的优势在于处理信息的能效比,毫无疑问的遥遥领先。另外,在创新能力方面,还有待 AI 不断进化。
人类处理的是自然语言,大模型处理的则是 token。token 数量过少会导致知识被高度压缩,从而显著降低模型对世界的感知能力。若将 token 数量提升到像素级别,又会导致无关信息过载,在现有结构(大脑容量 / 模型参数量)和能耗限制下无法有效处理。因此需要一种算法来平衡这种选择。
BPE 算法
BPE 算法是当前大模型普遍采用的 tokenizer 算法,不同模型的具体实现虽有差异,但核心算法逻辑大体雷同。
BPE(Byte Pair Encoding),顾名思义,其核心在于字节对编码。需注意以下几点:
-
字节的来源: 比特是现代计算机处理的最小单位,字节是基于比特之上的通用处理单元。自然语言文本在计算机中也是以字节形式表达(通常是 UTF-8 编码)。BPE 算法强制采用 UTF-8 编码来编解码自然语言文本。
-
字节的边界: 如前所述,BPE 算法操作的基本单位是文本 UTF-8 编码后的字节。然而,在应用 BPE 之前,通常需要对原始文本进行预分词(pre-tokenization)。例如,GPT-4 使用一个正则表达式来定义文本边界,该表达式如下:
fn get_gpt4_pattern() -> String {
	r"'(?i:[sdmt]|ll|ve|re)|[^\r\n\p{L}\p{N}]?+\p{L}+|\p{N}{1,3}| ?[^\s\p{L}\p{N}]++[\r\n]*|\s*[\r\n]|\s+(?!\S)|\s+".to_string()
}
它识别并特殊处理了英文常见缩写(如 ‘ll, ‘re)、数字(仅取连续 3 位)、多语言字符、标点符号等。以下代码示例有助于直观理解预分词的效果:
let bpe = TiktokenBPE::new();
let text = "I'll go to the store. Email: user@example.com, Price: $99.99. 🔥🚀❤️ \n 你好世界こんにちは世界Здравствуй мир \n DeepSeek R1 模型已完成小版本升级, 当前版本为 DeepSeek-R1-0528。";
let tokens = bpe.pre_tokenize(text);

println!("{:?}", tokens);

// ["I", "'ll", " go", " to", " the", " store", ".", " ", " Email", ":", " user", "@example", ".com", ",", " Price", ":", " $", "99", ".", "99", ".", " 🔥🚀❤\u{fe0f}", " \n", " ", " 你好世界こんにちは世界Здравствуй", " мир", " \n", " DeepSeek", " R", "1", " 模型已完成小版本升级", ",", " ", " 当前版本为", " DeepSeek", "-R", "1", "-", "052", "8", "。"]- 启发式算法流程: 在确定了基本操作单位(字节)及其边界(通过预分词,并将其转化为 UTF-8 字节数组)后:
- 初始化词汇表: 首先用 ID (0 - 255) 分别对应最初的 256 个可能的字节。
- 迭代合并: 遍历所有预分词单元内部的相邻两个 ID(注意,这里操作的对象是基于词汇表的 ID 词符,而非原始字节),找出在整个语料中出现频率最高的 ID 对(pair)。将此 ID 对合并为一个新的 ID,并将其加入词汇表。
- 重复: 重复上述查找最高频 ID 对并合并的过程,直至达到目标词汇表大小。
代码实现
以下通过 Rust 语言实现一个并发训练的 BPE tokenizer 算法。
BPE 算法的核心流程包含以下步骤(如下图所示):
- 预分词与计数: 对所有语料文本进行预分词 (
pre_tokenize),并记录每个分好的单元(token)出现的频率。 - 字节化: 将每个单元转换为其对应的 UTF-8 字节序列 (
word_to_bytes)。 - 初始化词汇表: 初始化基础词汇表,包含 256 个 ID,分别对应 0 到 255 的字节值。
- 统计 ID 对频率: 遍历所有单元内部的相邻两个 ID(在合并过程中,单元会被表示为 ID 序列),统计所有可能的相邻 ID 对 (
pair) 在整个语料中出现的频率 (pair_counts)。 - 选取最高频对: 获取出现频率最高的那个 ID 对 (
best_pair)。 - 合并更新: 用一个新的 ID 替换语料中所有出现该
best_pair的地方。更新每个单元的内部表示(合并后的 ID 序列),并相应地更新词汇表(添加新的合并 ID)。 - 循环迭代: 重复步骤 4 至步骤 6,直到达到目标词汇表大小。
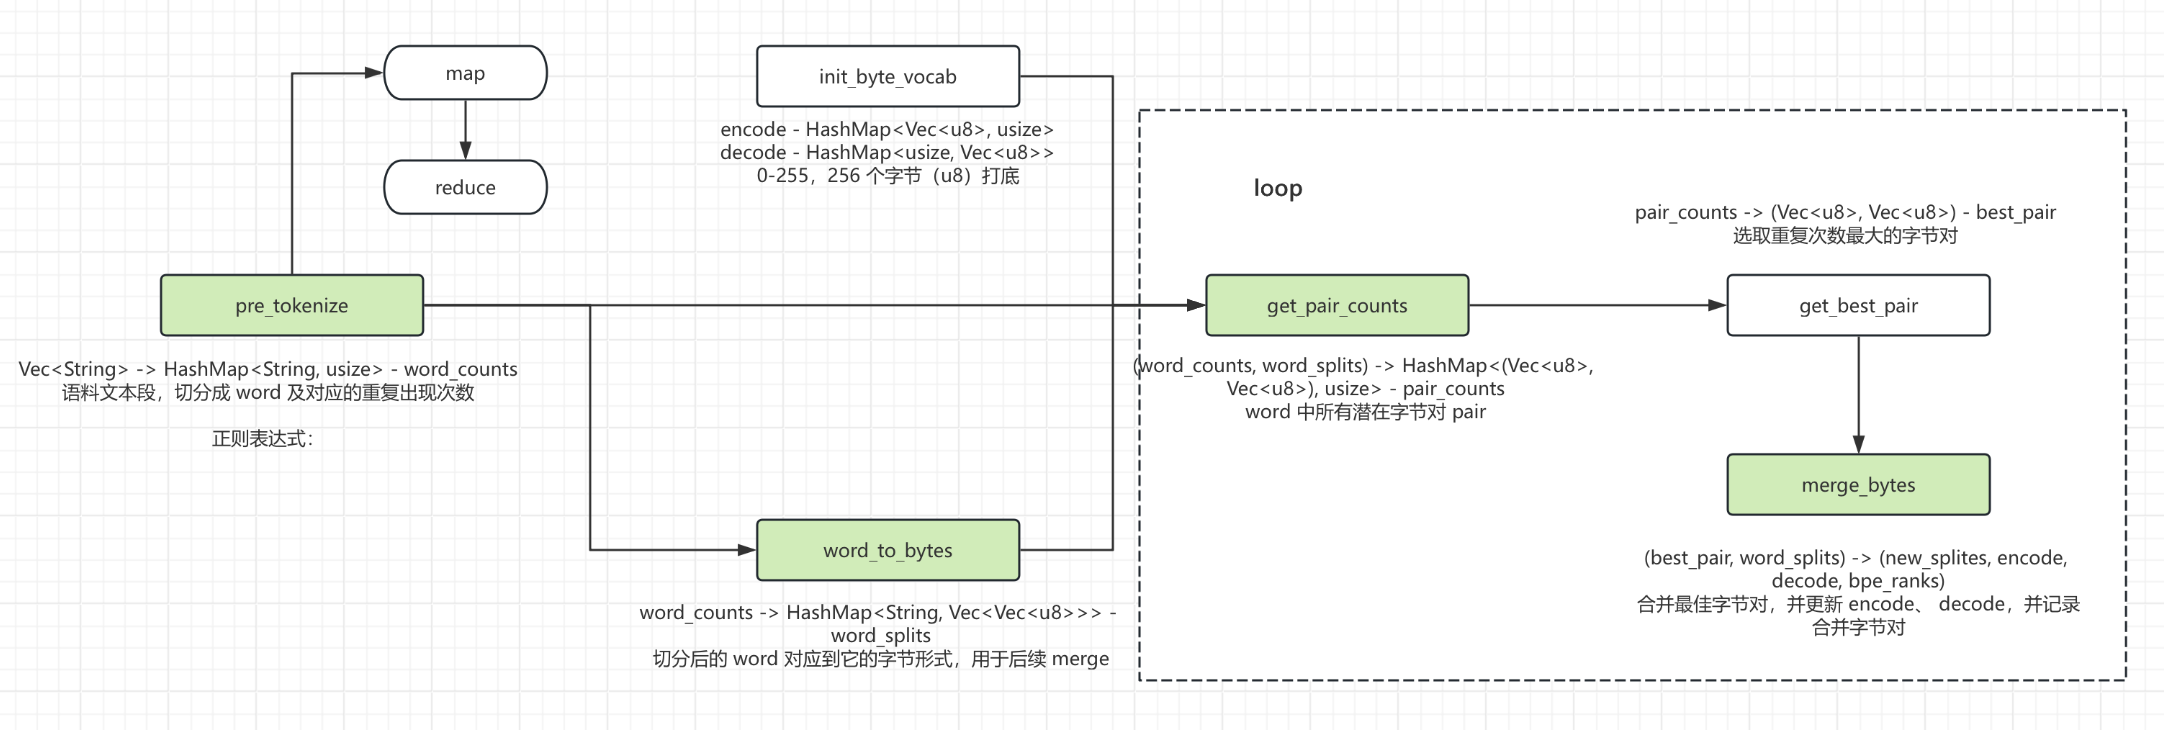
需要注意的关键点:
- 并发实现思路: 图中的绿色框标识了采用并发处理的步骤。这种并发设计与典型的 Web 服务器处理并发请求的模式不同(后者请求间相互独立,状态保存在外部存储)。BPE 训练算法存在全局状态(如全部
pair_counts的计算),不同语料片段的训练不能完全独立并发处理。流程中存在着严格的步骤间依赖关系(按箭头方向)。其并发模式类似于 MapReduce,在不同计算阶段(如计数阶段pair_counts的计算、合并阶段的替换更新操作)内部尝试进行并行化处理。 - “词符对”(pair) 的含义: 这里的
pair指的是单元内部相邻的两个 ID(词符 ID)。这些 ID 可以代表单个字节(初始化阶段),也可以是先前合并形成的代表字节序列的合并词符 ID。本文的 Rust 实现直接操作字节序列(或合并后的字节序列),而 karpathy minbpe 实现则基于数字 ID。 - Rust 并发实现代码: 详见文末附录。代码主要由 Cursor 生成,并经过几次优化调整。
性能对比
测试环境
- 机器: MacBook Pro M1 (10 核:8 性能核 + 2 能效核) 32GB RAM
- 数据集: 从 https://www.modelscope.cn/datasets/Data-Juicer/redpajama-book-refined-by-data-juicer/resolve/master/redpajama-book-refine-result-preview.jsonl 中提取的
text字段内容。 - 实现对比:
- Rust: 本文实现 (单线程 & 并发)
- Python: karpathy minbpe (单线程,作为性能基准)
性能结果
| 实现方式 | 数据量 | 目标词汇量 | 训练时间(秒) | 相对性能 (vs Python 单线程) |
|---|---|---|---|---|
| python 单线程 (karpathy minbpe) | 10 文档,520,275 tokens | 500 | 86.33 | 1.0X (基准) |
| rust 单线程 | 10 文档,520,275 tokens | 500 | 34.05 | ~2.5X |
| rust 并发 | 10 文档,520,275 tokens | 500 | 18.94 | ~4.6X |
| python 单线程 (karpathy minbpe) | 30 文档,2,263,770 tokens | 1000 | 1033.80 | 1.0X (基准) |
| rust 单线程 | 30 文档,2,263,770 tokens | 1000 | 223.59 | ~4.6X |
| rust 并发 | 30 文档,2,263,770 tokens | 1000 | 126.05 | ~8.2X |
分析
- Rust 实现在性能上显著优于 Python 单线程实现。
- 随着数据集规模(语料量和目标词汇量)的增加,Rust 相对于 Python 的性能优势更加明显(从 4.6X 提升到 8.2X)。
- Rust 单线程版本和并发版本的性能提升倍率相对稳定(并发加速比在 1.8X 左右)。在并发训练过程中,机器的 10 个核心资源利用率接近饱和,而单线程实现仅使用了一个核心。
参考资料
- CS336: Language Modeling from Scratch
- Let’s build the GPT Tokenizer
- openai tiktoken
- google sentencepiece
- https://tiktokenizer.vercel.app/
- https://github.com/karpathy/minbpe
代码附录
Rust 并发实现代码
pub struct TiktokenBPE {
    /// 编码器:token -> rank (优先级)
    pub encoder: HashMap<Vec<u8>, usize>,
    /// 解码器:rank -> token
    pub decoder: HashMap<usize, Vec<u8>>,
    /// 特殊 token 映射
    pub special_tokens: HashMap<String, usize>,
    /// 预分词正则表达式模式
    pub pattern: String,
    /// 编译后的正则表达式
    pub regex: Option<Regex>,
    /// BPE 合并规则 (rank1, rank2) -> new_rank
    pub bpe_ranks: HashMap<(Vec<u8>, Vec<u8>), usize>,
}
pub fn train_parallel(&mut self, corpus: &[String], vocab_size: usize) {
// 1. 真正的多核并行预分词
let chunk_size = (corpus.len() / rayon::current_num_threads()).max(1);
let local_results: Vec<_> = corpus
.par_chunks(chunk_size)
.map(|chunk| {
let mut local_word_counts = HashMap::new();
let mut local_total_tokens = 0;
for text in chunk {
let tokens = self.pre_tokenize(text);
local_total_tokens += tokens.len();
for token in tokens {
*local_word_counts.entry(token).or_insert(0) += 1;
}
}
(local_word_counts, local_total_tokens)
})
.collect();
// 并行合并结果
let (word_counts, total_tokens) = local_results
.into_par_iter()
.reduce(
|| (HashMap::new(), 0),
|(mut acc_counts, acc_tokens), (local_counts, local_tokens)| {
for (token, count) in local_counts {
*acc_counts.entry(token).or_insert(0) += count;
}
(acc_counts, acc_tokens + local_tokens)
}
);
// 2. 初始化字节级词汇表
self.init_byte_vocab();
// 3. 并行将每个 word 分解为字节序列
let word_splits: HashMap<String, Vec<Vec<u8>>> = word_counts
.par_iter()
.map(|(word, _)| {
let bytes: Vec<Vec<u8>> = word.bytes().map(|b| vec![b]).collect();
(word.clone(), bytes)
})
.collect();
// 4. 迭代合并最频繁的字节对
self.train_merge_loop_parallel(word_splits, word_counts, vocab_size);
}/// 初始化字节级词汇表
fn init_byte_vocab(&mut self) {
// 添加所有可能的字节值 (0-255)
for i in 0..256 {
let byte_token = vec![i as u8];
if !self.encoder.contains_key(&byte_token) {
let rank = self.encoder.len();
self.encoder.insert(byte_token.clone(), rank);
self.decoder.insert(rank, byte_token);
}
}
}/// 并行合并循环
fn train_merge_loop_parallel(
&mut self,
mut word_splits: HashMap<String, Vec<Vec<u8>>>,
word_counts: HashMap<String, usize>,
vocab_size: usize,
) {
while self.encoder.len() < vocab_size {
// 并行计算字节对频率
let pair_counts = self.get_pair_counts_parallel(&word_splits, &word_counts);
if pair_counts.is_empty() {
break;
}
// 找到最频繁的 pair,如果频率相同则按字典序选择以保证确定性
let best_pair = pair_counts.iter()
.max_by(|(pair1, &count1), (pair2, &count2)| {
count1.cmp(&count2).then_with(|| {
// 如果频率相同,按字典序比较以保证确定性
pair2.cmp(pair1) // 注意这里是 pair2.cmp(pair1) 以保持一致的排序
})
})
.map(|(pair, _)| pair.clone());
if let Some((first, second)) = best_pair {
// 创建新的合并 token
let mut new_token = first.clone();
new_token.extend_from_slice(&second);
let new_rank = self.encoder.len();
self.encoder.insert(new_token.clone(), new_rank);
self.decoder.insert(new_rank, new_token);
// 记录合并规则
self.bpe_ranks.insert((first.clone(), second.clone()), new_rank);
// 真正多核并行更新所有单词的分割
let items: Vec<_> = word_splits.into_iter().collect();
let chunk_size = (items.len() / rayon::current_num_threads()).max(1);
word_splits = items
.into_par_iter()
.chunks(chunk_size)
.flat_map(|chunk| {
chunk.into_par_iter().map(|(word, splits)| {
let new_splits = self.merge_bytes(&splits, &first, &second);
(word, new_splits)
})
})
.collect();
} else {
break;
}
}
}/// 真正多核并行计算字节对的频率
fn get_pair_counts_parallel(
&self,
word_splits: &HashMap<String, Vec<Vec<u8>>>,
word_counts: &HashMap<String, usize>,
) -> HashMap<(Vec<u8>, Vec<u8>), usize> {
// 将工作分成多个块,每个核心处理一块
let items: Vec<_> = word_splits.iter().collect();
let chunk_size = (items.len() / rayon::current_num_threads()).max(1);
items
.par_chunks(chunk_size)
.map(|chunk| {
let mut local_pair_counts = HashMap::new();
for (word, splits) in chunk {
let count = word_counts[*word];
for i in 0..splits.len().saturating_sub(1) {
let pair = (splits[i].clone(), splits[i + 1].clone());
*local_pair_counts.entry(pair).or_insert(0) += count;
}
}
local_pair_counts
})
.reduce(
|| HashMap::new(),
|mut acc, local_counts| {
for (pair, count) in local_counts {
*acc.entry(pair).or_insert(0) += count;
}
acc
}
)
}