机器学习基础
前言:此部分文章并非系统性的教学文章,网络上已经很多非常优秀的教学课程,顶尖且免费。比如,哔哩哔哩上李沐大神的《动手学深度学习 v2》,Andrej Karpathy 在 YouTube 上教程,以及 Standford CS224N 课程。 这里主要记录作者的一些理解,有意思的知识点,或者豁然开朗的乐趣,希望你也能喜欢!
我们将通过 Pytorch 文档自带的案列进行讲解、分析机器学习的基本流程。此案列使用 Pytorch 最基础的核心组件 Tensor,来实现一个丐版(算不上,只能说玩具版)机器学习模型(非 LLM)训练。
Tensor 你可以暂时把它理解为,一个承载数据的多维数组,用于后续的矩阵计算。当然它的功能不止于此。
import torch
import math


dtype = torch.float
device = torch.device("cpu")
# device = torch.device("cuda:0") # Uncomment this to run on GPU

# Create random input and output data
# 1. 准备训练数据
x = torch.linspace(-math.pi, math.pi, 2000, device=device, dtype=dtype)
y = torch.sin(x)

# Randomly initialize weights
# 5.2 参数:模型参数初始化
a = torch.randn((), device=device, dtype=dtype)
b = torch.randn((), device=device, dtype=dtype)
c = torch.randn((), device=device, dtype=dtype)
d = torch.randn((), device=device, dtype=dtype)

# 5.2 超参数:学习率初始化
learning_rate = 1e-6
# 5. 训练模型
# 5.1 迭代次数,即使用训练样本数据的次数;2000 是模型训练的迭代次数,用 epochs = 2000 变量定义更合适
for t in range(2000):
    # Forward pass: compute predicted y
    # 2. 定义 model,包含了需要学习的参数 a,b,c,d,以及
    # 5.3 计算,通过模型计算出样本对应的目标值 y_pred
    y_pred = a + b * x + c * x ** 2 + d * x ** 3

    # Compute and print loss
    # 3. 定义损失函数,这里使用了非标准的均方差损失函数(少除以样本数量 len(x))
    # 5.4 偏差,通过损失函数获取与目标值之间的偏差
    loss = (y_pred - y).pow(2).sum().item()
    if t % 100 == 99:
        print(t, loss)

    # Backprop to compute gradients of a, b, c, d with respect to loss
    # 4. 定义优化算法,这里使用最原始的批量梯度下降算法
    # 5.5 梯度计算,完成模型中的所有参数(即上述定义的 a b c d tensors)的梯度计算
    grad_y_pred = 2.0 * (y_pred - y)
    grad_a = grad_y_pred.sum()
    grad_b = (grad_y_pred * x).sum()
    grad_c = (grad_y_pred * x ** 2).sum()
    grad_d = (grad_y_pred * x ** 3).sum()

    # Update weights using gradient descent
    # 5.6 更新参数,结合学习率、梯度,完成参数更新
    a -= learning_rate * grad_a
    b -= learning_rate * grad_b
    c -= learning_rate * grad_c
    d -= learning_rate * grad_d


print(f'Result: y = {a.item()} + {b.item()} x + {c.item()} x^2 + {d.item()} x^3')
在案列源代码基础上,做了进一步的注释,简要勾勒出机器学习模型训练的几个步骤,为后续 Pytorch 更高阶抽象做准备。而不会阅读他人训练代码,简单几行实现,却不知其实现原理而慌乱。
短短 50 来行示例代码,麻雀虽小五脏俱全,基本包含机器学习模型训练的核心流程。特别针对神经网络算法,因为梯度下降是神经网络的基础算法。
1. 数据准备
代码中使用了随机生成的样本数据和目标值。当然实际情况,要远复杂的多。大部分实操过程中,样本数据的采集、清洗,会占用总体工作时间的 80% 左右。
大语言模型对数据量要求非常大,而且质量要求也很高。好的一方面是,作为当今最炙手可热的研究领域,很多数据源都能相对便捷的获取。
无论是计算机的兴起与普及,还是机器学习领域的研究和发展,英语国家无疑依旧处于领先地位。因此英文数据资源在质量和数量上也会先行一步,不过国人也在努力,自发、无偿的在做一些事情,致敬!MNBVC. 超大规模中文语料集・NLP 自然语言处理数据集
再来看示例代码中的样本数据的数据结构,X、Y 都是 1 * 2000 的 tensor,代表了 2000 个样本数据。不过多解释数据,随意找一本机器学习的教材都会有充实的讲解。这里我们来纠正几个概念,
- 不是所有模型需要 Y,聚类算法就不需要。
- 有监督、无监督算法和有没有 Y 无关,有无监督代表着需不需要人工介入。有监督往往需要人工介入标注 Y。但无监督并不意味没有 Y,比如大语言模型 pretrain 阶段,所需语言文本无需人工标注,后续你会看到后一个 “字” 就是前一段文字的 Y。
2. 模型定义
示例代码为了方便,模型定义与计算放到了一起。后面我们会对代码做进一步优化、抽象,你会发现自然而然解决 Pytorch 的抽象。示例模型是个如下一元高次多项式,
模型包含了 4 个参数 a b c d 需要进行学习。
模型方面,稍作展开。上述是个多项式模型,一个特征 x 预测目标值 y。而实践中,能够获取远不止一项,同时又要兼顾不至于引入过大的计算复杂度,因此通常会使用如下线性模型(多元一次多项式),
即
早期神经网络的典型算法,多层感知机,就是由不同线性模型组成。脱胎于神经网络算法的大语言模型也有大量使用线性模型,也叫全连接。
3. 损失函数
损失函数用于衡量样本数据,通过模型计算出来的目标预测值(y_pred),与样本采集的目标值(y)之间损失(loss)。
均方差损失(MSE)作为损失函数,具备统计学意义。基于 1)样本数据是独立,2)计算得到的损失(loss)呈正态分布,这两个假设前提下,可以证明损失最小时,样本的联合概率最大。
大语言模型中,通常会选用 Cross Entropy 作为损失函数。因为大语言模型是个多分类问题,适合 Cross Entropy。而 MSE 更适合回归类问题。
4. 优化算法
大语言模型学习是个 NP 问题,梯度下降已经成为求解大语言模型的事实核心算法,迄今没有其他选择。
示例代码,使用最原始的批量梯度下降算法(BGD),一次迭代,使用全量样本数据求解梯度,更新参数。作为示例,使用此算法是合理的,因为只有 2000 个样本数据。
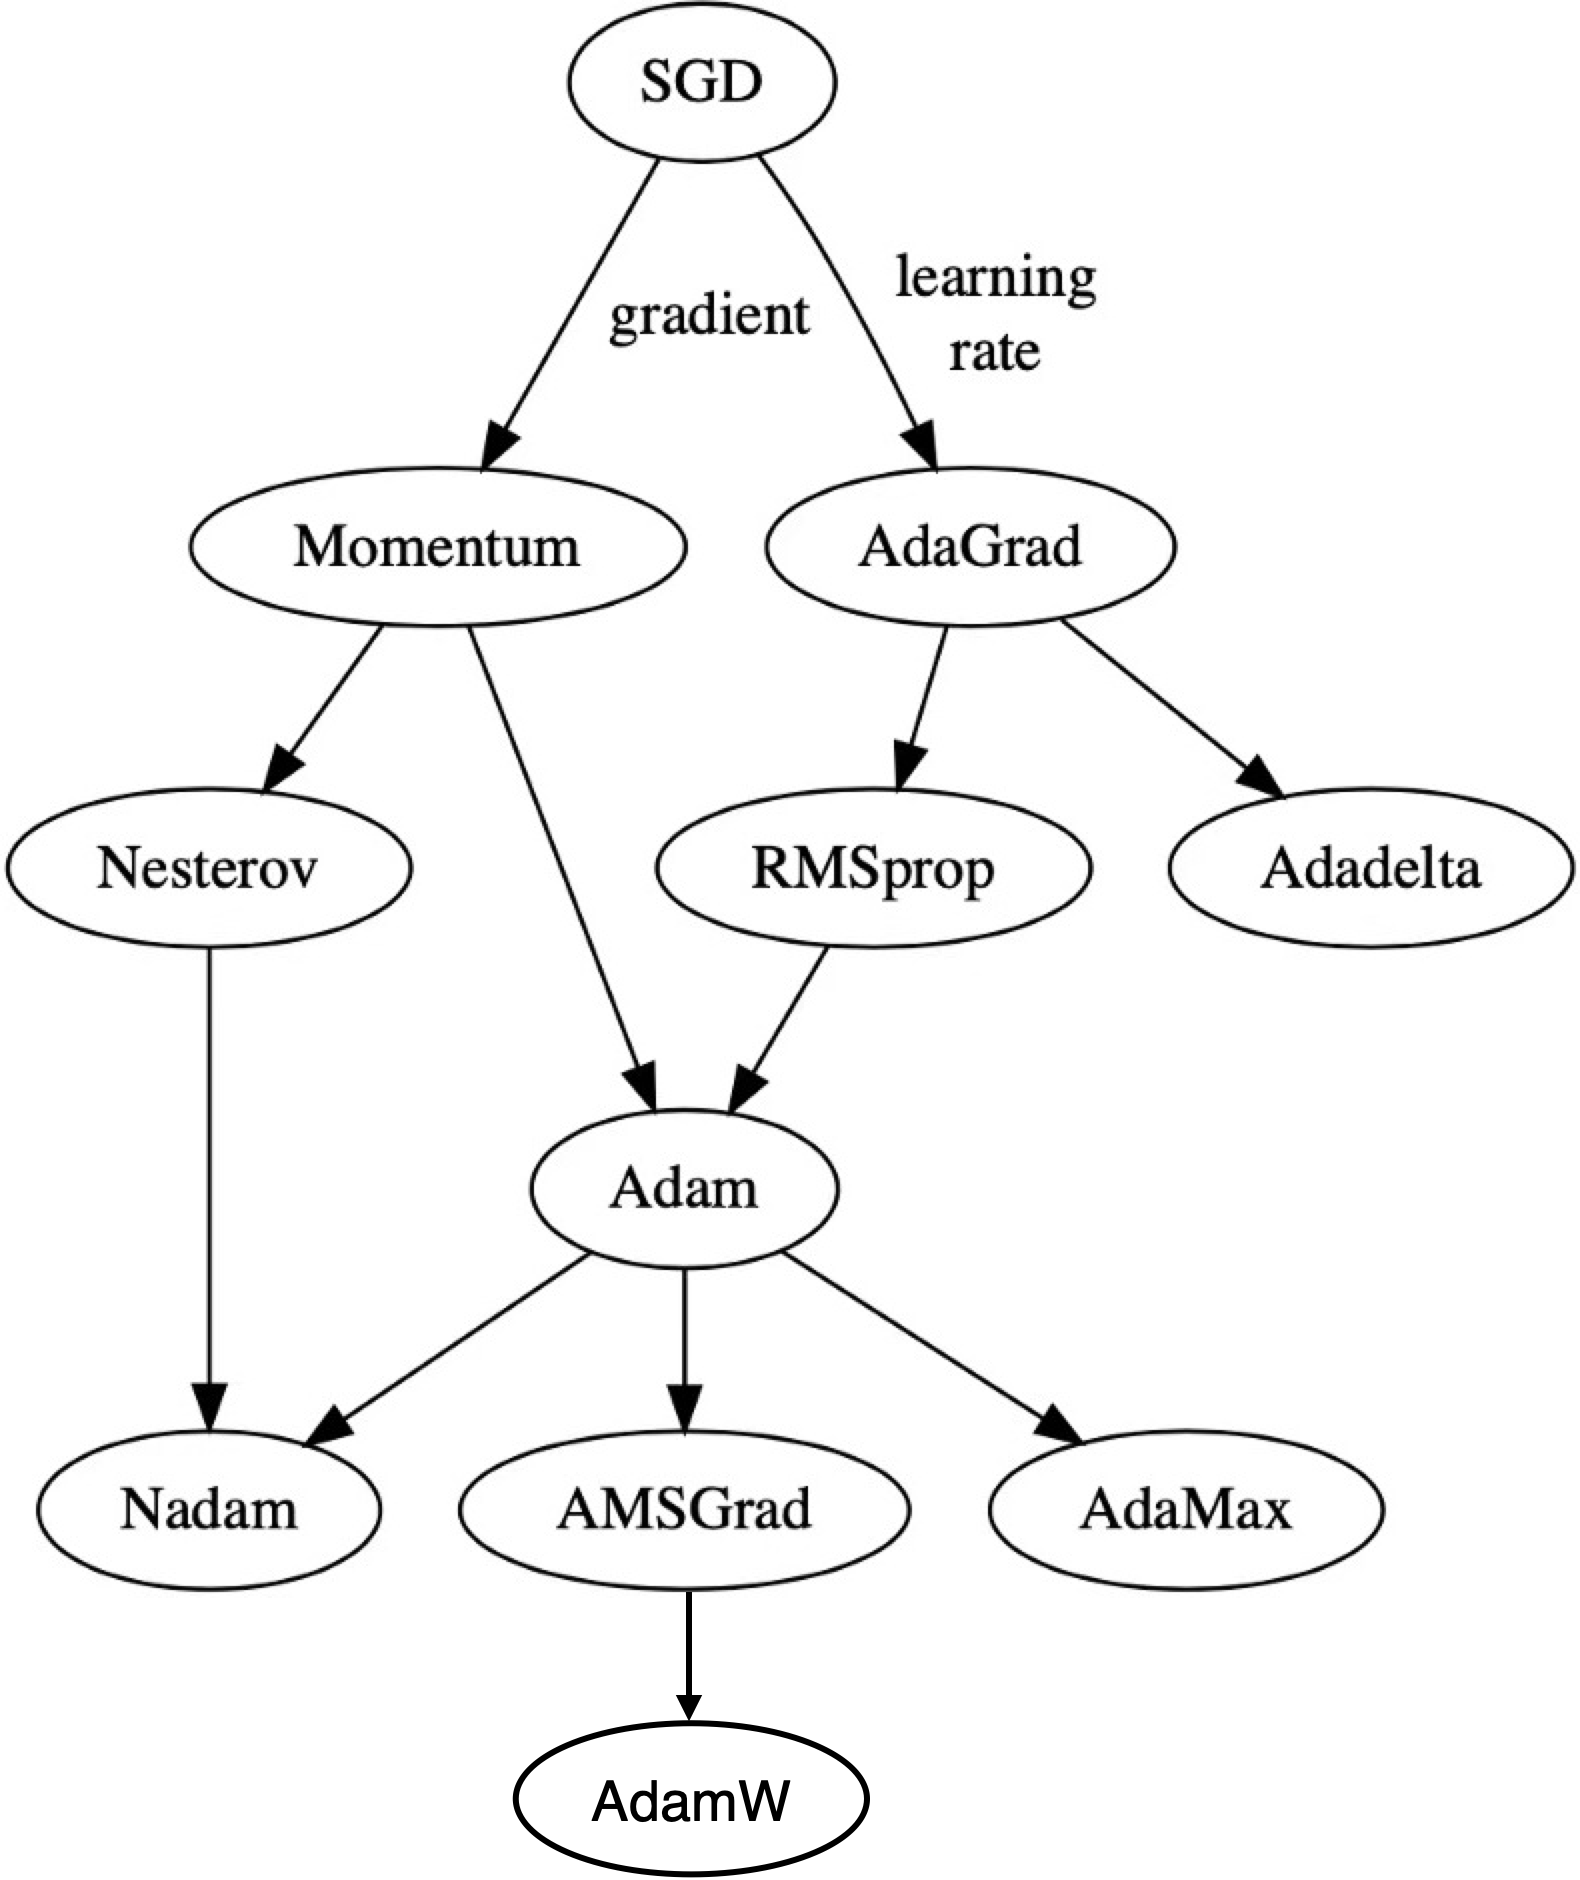
而对应大语言数据模型而言,这就是不可能完成的任务了,ChatGPT 3.5 就用了 40T 数据。我们经常听到的 SGD 就是为了解决大数据情况下,计算量过大的情况,随机选用一个样本数据计算梯度,计算量最小。
显然 SGD 也有其缺点,实际项目中会使用其变种算法。由 Meta 最新开源的 LLama2 使用 AdamW 优化算法。
5. 模型训练
示例代码是为了演示,如何使用 Pytorch 进行模型开发,不需要很好的工程抽象,因此模型训练逻辑散乱在代码各处。
5.1. 迭代
迭代是为了定义在模型训练过程中,如何使用样本数据。示例代码中是指对样本数据使用的次数。而在大语言模型训练的实践过程中,因为不同来源语料的质量不同,模型知识侧重点不同,会以迭代次数的形式来使用这些样本预料数据。且迭代次数并不会像示例代码一般,一定是整数倍。
Llama2 pretrain 模型,对大多数训练数据仅使用 1 次或者更少,Github 的数据就只使用了 60%。而来自 Wiki 和书籍的数据,会被使用 2 次。
5.2. 参数 超参数
- 参数
模型定义完成,目标是训练模型中的参数。
如果是从头开始训练,就需要人工对参数做初始化。示例代码中,使用随机数初始化模型参数。当然也可以统一初始化为 1 或者其他值。
如果训练中断或者做 fine-tuning,那么直接读取 checkpoint 或者 pretrain 模型,使用训练过程中的参数值即可。
- 超参数
超参数与参数一字之差,但作用天壤之别。
参数是需要训练得到的,也是我们进行模型训练的目标。而模型训练中的超参数,是需要人工调整的,用来更好的训练参数,获取更好的模型性能。
此处只展示了一个超参数:学习率。在实践过程中,超参数个数要多许多。不停的尝试调整不同的超参数,是机器学习工作过程的日常。无论多么有创新力,有活力的人类活动,多有枯燥、“苦力” 的一面,包括数据收集和清洗,包括超参数调优。
5.3. 计算
计算样本特征数据,得到对应的目标值。此过程在模型上线阶段,我们称其为预测。
这里需要注意的是,利用矩阵计算,此行代码完成了所有样本数据计算。
5.4. 偏差
使用定义好的损失函数,计算预测值与样本目标值之间的偏差。
5.5. 梯度
分析代码,梯度计算看似与偏差计算(损失函数)无关。偏差计算使用定义损失函数 MSE,代入即可,毫无异议。但梯度计算的代码或者说计算公式,从何而来?
这就需要我们了解,这个梯度就是指该损失函数上不同参数的梯度,即此处参数 a b c d 在损失函数 MSE 的一阶导数:
对参数在损失函数 loss 上求导可得,
如源代码所示。
5.6. 参数更新
参数更新时,超参数学习率(learning_rate)就有了用武之地。梯度(一阶导数)只表明了一个方向,往梯度方向走最近(最正确)。学习率是为了控制步调,怕你步子太大,跨过了最优点(局部最优解),导致来回振荡无法收敛。
示例代码到了尾声,这部分介绍也到了尾声。
我们分析了 Pytorch 文档示例代码的同时,简要整理了机器学习过程中的核心过程,当然都是丐版过程都算不上的玩具板。任何一个过程单拎出来都是一门学问。