DeepSeek 671B 满血版 GPU 硬件选型调研报告
约 6 分钟原创工程实战#gpu#deepseek#inference
采购建议
结合厂商测试性能数据和供应商生态支持,如果还能买到且价格相差不大的前提下,建议采购英伟达 H20。
英伟达 GPU 对新模型架构的适配能力显著优于其他方案。成熟的 CUDA 生态不仅能够完美支持 DeepSeek 系列模型,同时也为未来可能部署的其他大模型提供了更好的兼容性和可扩展性。
注:测试数据显示,在常规应用场景(1k 上下文长度)下,各方案均能满足性能需求。但在长上下文场景(如 30k 级别的征信报告、财报分析等)中,性能会出现显著下降,需要关注。
部署 DeepSeek-R1 671B 满血版,我们需要需重点关注以下两点: GPU 核心指标和供应商生态支持。
另外还会着重考虑是否能单台 GPU 服务器部署,多台需要配套网络等其他设备,会使成本大幅提高。
一、GPU 核心指标
- 显存容量:全精度模型需 1.4TB+ 显存,FP8 量化需 800GB+,INT4 量化需 640GB+。
- 计算能力:FP16 算力需 ≥300 TFLOPS / 卡,以支持大规模矩阵运算。
- 显存带宽:建议 ≥4.8 TB/s(HBM3e 技术)以降低推理延迟。
- 多卡互联:需支持 NVLink、PCIe Fabric 或等效技术,带宽 ≥900 GB/s。(对于推理来说,PCIe 的速率已经够用)
- 功耗与散热:单卡功耗 ≤450W,支持液冷或高密度风冷。(运维需要考虑)
GPU 核心指标决定了模型能够提供的并发数量,token 延时、速率、吞吐等技术指标。
二、供应商生态支持
- 英伟达:CUDA 生态成熟,支持 vLLM/TensorRT 加速库
- 华为:昇思 MindSpore 框架,提供 FlashMLA 加速技术(推理速度提升 185%)
- 海光 / 沐曦:需定制化适配 PyTorch,部分支持 ONNX 导出
- AMD:构建开放的 ROCm(Radeon Open Compute)生态系统,支持 PyTorch 3.0 和 TensorFlow 3.0 框架
供应商生态支持直接影响新模型适配能力、技术响应速度以及问题解决效率。
三、关键对比与建议
| 指标 | 英伟达 H100 | 英伟达 H20 | AMD MI308 | 昆仑芯 P800 | 华为 Atlas 800I(910B) | 华为昇腾 910C | 海光 HGX-200 | 沐曦 C550 |
|---|---|---|---|---|---|---|---|---|
| 单卡显存容量 | 94GB HBM3e | 96GB/141GB HBM3e | 96GB HBM3e | 64GB HBM3e | 64GB HBM3e | 64GB | 48GB | 48GB |
| 8 卡总显存 | 752GB | 768GB/1.13TB | 768GB | 512GB | 512GB | 512GB | 384GB | 384GB |
| FP16 算力 (TFLOPS) | 1,513 | 148 | 120(推测值) | 781 | 640 | 781 | 300 | 280 |
| 显存带宽 (TB/s) | 3.35 | 4.0 | 3.8(推测值) | 3.2 | 3.1 | 3.2 | 2.0 | 1.8 |
| 8 卡总价(万元) | ~146.4 | ~130 | ~100(推测值) | ~120 | ~200 | ~144 | ~80 | ~64 |
| 适用场景 | 训练 | 推理 | 推理 | 推理 | 推理 | 训练 | 推理 | 推理 |
四、三方厂商的测试数据
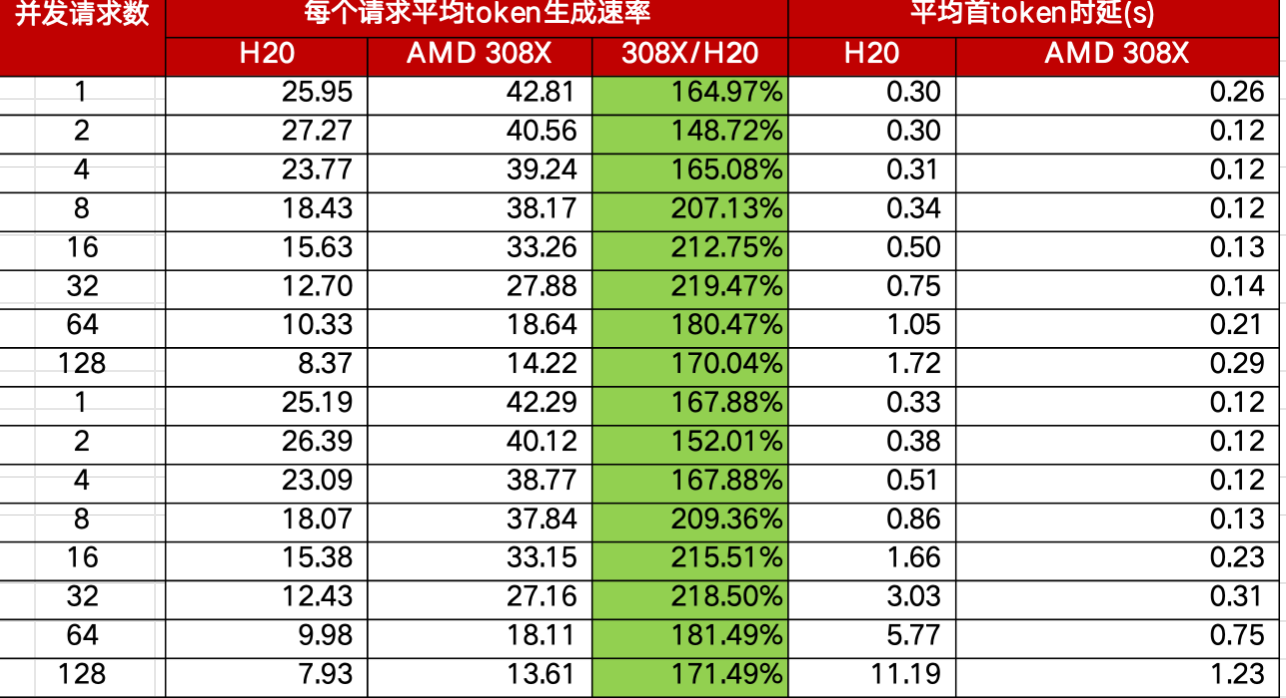
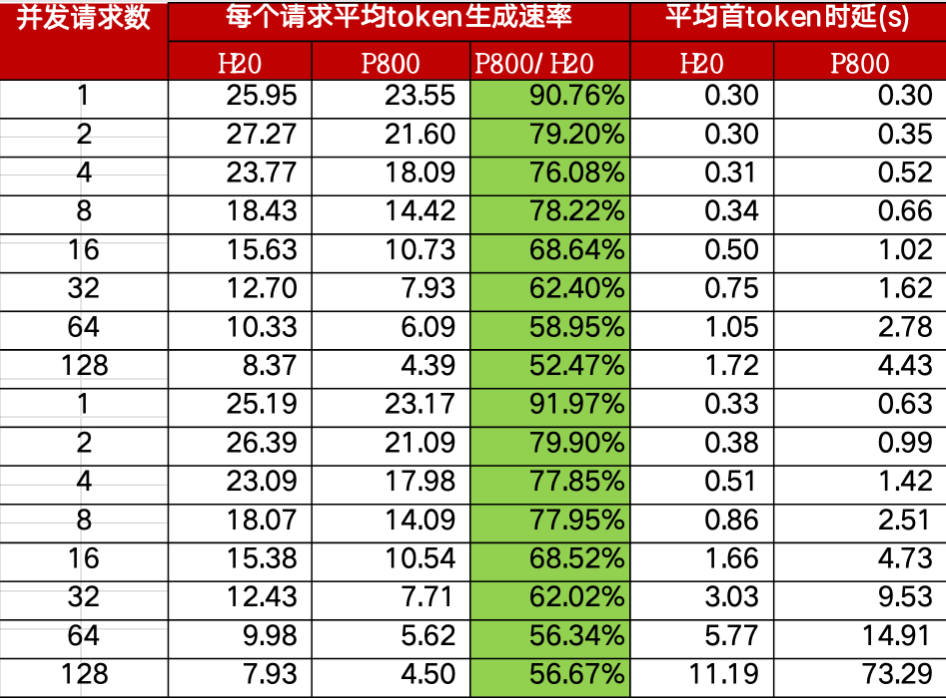
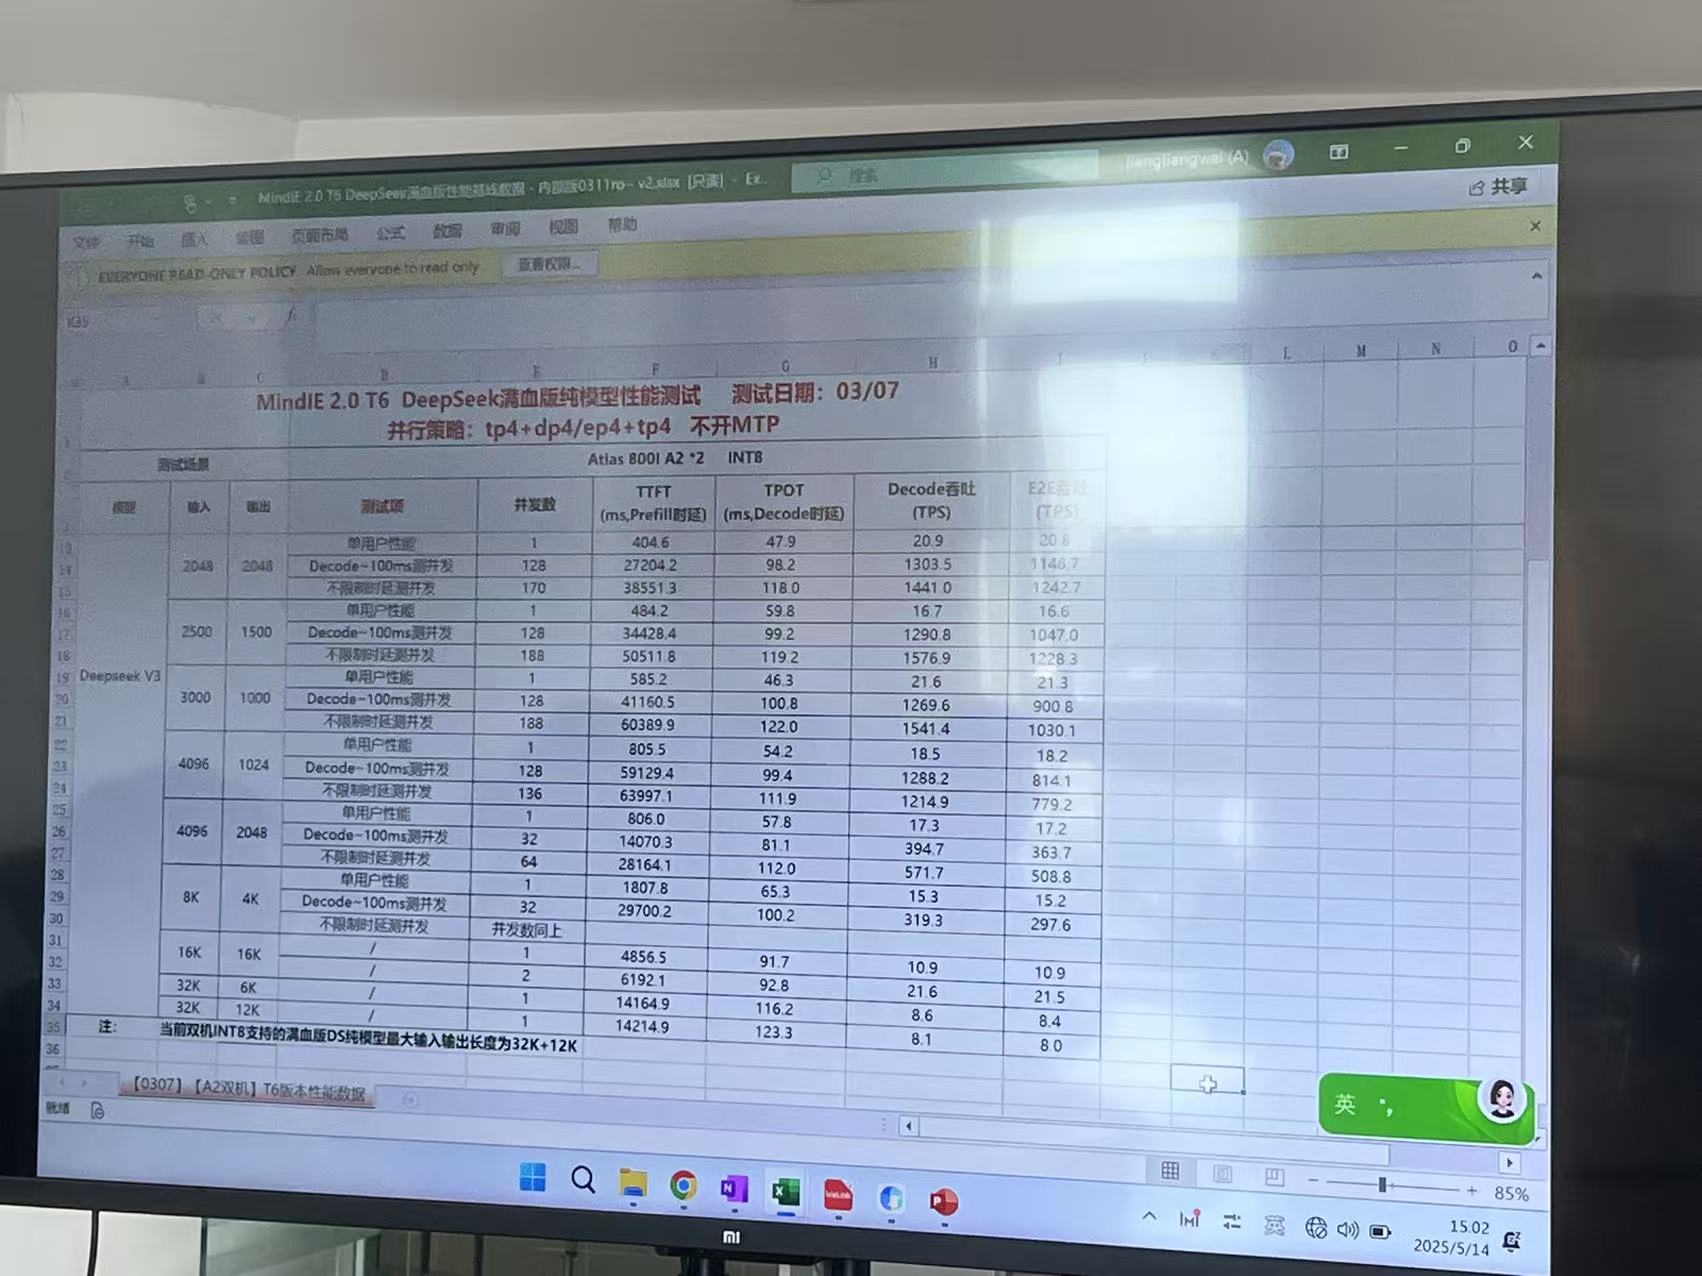
从厂商提供的性能指标来看,昆仑芯 P800、华为 Atlas 800I 和 AMD MI308X 与英伟达 H20 处于同一个数量级水平,其中 AMD MI308X 表现略优。
然而在生态支持方面,英伟达凭借成熟的 CUDA 生态优势明显。值得注意的是,国产 GPU 解决方案在价格方面可能并不具备明显优势。
测试数据显示,在常规应用场景(1k 上下文长度)下,各方案均能满足性能需求。但在长上下文场景(如 30k 级别的征信报告、财报分析等)中,性能会出现显著下降,需要关注。