Claude 3
AI 趣事
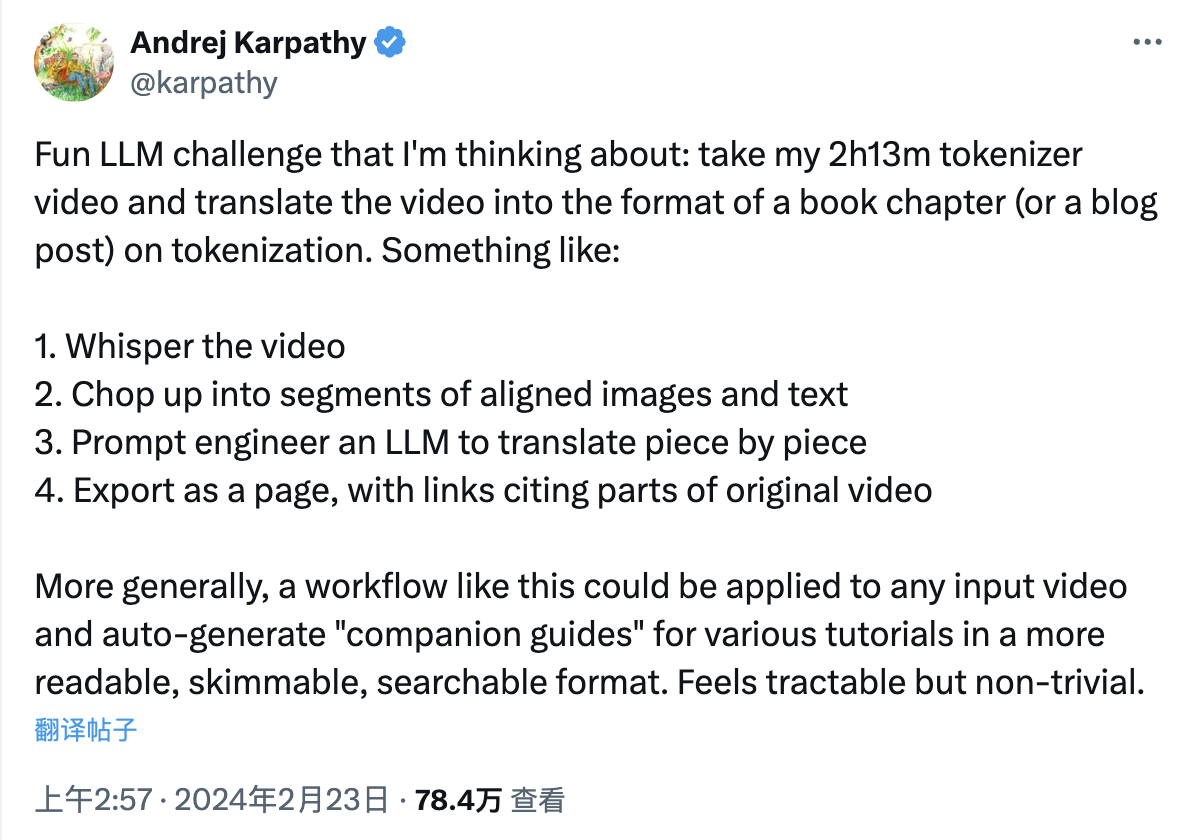
2 月 23 日,Andrej 最新发布了 Tokenization 相关的教学视频,正在为该教学视频转换成一本书的其中一个章节。然而,4 分钟的视频长度已经花了他超过半小时的时间,这个教学视频有足足 2 小时 13 分钟。 于是他在 X 上提出了这么一个挑战:是否能够通过现有的 LLM 技术来自动化的完成这项工作。初步想法如下:
- 首先将视频语音,通过 Whisper 转换成文字。
- 将转换后的文字和视频图片对应起来,切分成几大块。
- 然后,利用 LLM 将其一块一块的转义出需要的内容。
- 最后,用一个网页将产出的内容与原始视频对应起来。
3 月 5 日,一个叫 Emmanuel Ameisen 的 AnthropicAI 工程师完成了这项挑战。他使用 Claude 3 Opus,并在只构造了一个 prompt 的情况下,完成了此项任务。 https://twitter.com/mlpowered/status/1764718705991442622 从上述帖子来看,Emmanuel 实现逻辑与 Andrej 的想法基本吻合。
- 首先,他们将每隔 5s 对视频取帧,并与字幕脚本一一对应。这里没说使用了什么技术,应该不是 Whisper。
- 其次,将所有字幕脚本和对应图片分成 24 部分。这里他做了解释,Claude 支持的上下文(200k)能够一次性容纳所有脚本和图片,但是出于性能(响应时间)的考虑还是将内容分成了 24 块。
- 将 Andrej 的第 3 、 4 合并,直接使用 Opus 输出网页结果。 值得关注的是,他们在设计 prompt 时,除了内容和一些常规技巧外,额外添加了两张 Andrej 早前文章截图,用于 Opus 模仿生成类似风格的文章。 !X2Twitter.com_GH2JKj0acAA8H38 (gif).mp4 同日,Andrej 给了比较高的评价。
- 首先,在网页内容的布局风格上,无可挑剔。
- 指出了内容中几处问题,总体上瑕不掩瑜。Impressive!
- 最后,Andrej 对 Claude 表达了强烈兴趣,并揶揄了一下对现行 LLM 模型只只注重测试集评分,而忽略实际使用体感的现象。
Claude 3
回过头来,我们再来看 Anthropic 最近发布的 Claude 3。从报道上看,Claude 3 在所有测试集上又全面超越 ChatGPT 4。 鉴于 Gemini 的前车之鉴,Anthropic 又是 Google 投资的,对 Claude 3 还是充满戒心的,担心会不会又是一场闹剧。(后续有八卦披露, Gemini 测试集的评分高于 ChatGPT 4 的原因,要么通过调整 prompt 几十次中选一次最好的做最终结果;或者用 5-shot 跟 0-shot 做比较。) 虽然没具体看过上述事件生成网页的具体内容,无疑 Andrej 的回复是最具权威性的,总体可以用 impressive 来形容。 本人在 claude.ai 上体验了一把 Claude 3 Sonnet(Claude 3 的中杯),多模态的能力表现,感觉非常好。虽然在纯文字形式的回答上,几个案例都稍逊 ChatGPT 4,但差距不大,有理由相信 Claude 3 的大杯 Opus 不会比 ChatGPT 4 差。因没有机会使用 ChatGPT 的多模态,Sonnet 的多模态使用下来体验还是非常棒的👍。 我们再从以下几个角度审视一下 Claude 3。
商业模式
Claude 3 采用了 Gemini 相同的商业策略,对产品分级,分别是 Haiku(未发布)、Sonnet(免费)、Opus(商用)。 对商业模式没有太多发言权,但是对于面向大众的 AI 产品,按当前 LLM 发展而言,梯度版本产品未必是一个好的策略。 我更喜欢将 LLM 的商业策略与电信做类比,而不是手机、汽车、电脑等。ChatGPT 新一代取代老版本的商业策略才讲得通,原因有三:
价格
从现在 LLM API 的定价来看,ChatGPT 可以说是标杆,但总体而言是便宜的。对于大众而言,使用频率和量不会很大。 本人使用 ChatGPT 还算频繁了,每个月的 API 账单也差不多在 10 块人民币左右。 正如电信 3G、4G、5G,对于大众总体的流量费用较低,在可承受范围之内,价格不敏感。而且随着技术的进步,成本无疑会一步步下行,价格自然只会更低。 2B 场景可能会有费用方面的考虑,比如客服通话记录的质检等。
体验
不同能力的模型体验差距较大。正如 3G -> 4G -> 5G,能够明显感觉代际差,无疑 LLM 模型也是如此,不然也就没有必要做版本区分了。
响应时间
响应时间对体验的影响可以忽略。 小杯存在的原因,除了价格外,另一个重要的理由就是响应时间。其实对于大众应用而言,现在 ChatGPT 4 的响应时间(3s 左右)已经基本够用。以现有的发展势头,肯定会以肉眼可见的速度,足以满足大部分应用对响应时间的要求。 也只有在自动驾驶、后续在金融行业中可能应用的量化交易才会有超额需求(毫秒必争),而这也已经不是面向大众的产品了。
技术指标
接下来介绍 Claude 的几个技术指标,当然不会引用报道中的测试集分数。
多模态
再次向 Sonnet 的体验表达敬意🫡,体验很不错。
长上下文
Claude 3 已经能够支持到 200k token,ChatGPT 4 也已经支持到 128k,两者之前的差距对于 99.99% 的应用而言可以忽略。 再者,过长的上下文多少对模型的性能(不止是响应时间)有所影响。上述事件中提及的,有关 Emmanuel 把视频图片和脚本内容分成 24 份的原因是响应时间,并做了着重强调。个人以为是比较牵强的,应该更多是在质量性能影响方面的考量。
为什么是 Anthropic?
这是一个很有意思的话题。LLM 热热闹闹一年多,其他厂商基本都是 OpenAI 的跟随者,商业化方面更无出 ChatGPT 之右。 当初,深度学习,AI 方向业界绝对扛把子,作为 Transformer 发祥地的 Google,近 2 年默默无闻,Gemini 的一场闹剧外,地位更是一落千丈。 而 Meta 作为开源新秀,风头一时盖过大哥不少。 Google 投资的 Anthropic,却在一众大厂中脱颖而出,但也不意外。除却 Anthropic 身上 OpenAI 的血统,Claude 前 2 个系列,虽然和 ChatGPT 有一定差距,也稳居第二梯队。 微软投资了 OpenAI,Google 投资了 Anthropic,两个巨无霸本身没有另人惊艳的 LLM 产品,却在各自投资的创业公司,杨柳成荫。 个人看法,除却 “创业”、“人才” 几个关键词外(其实在如此热门的领域,很多创业公司的在这两方面都不逊色),一个是积淀,另一个原因还可以反归功于这两个巨无霸本身。 最近十几年来,可以说 Google 引领着计算机基础设施和技术方向,这方面微软也没落后,同处第一梯队。 对于 ChatGPT 级别模型的训练,光有钱是不够的,几十、几百张卡同时训练,可能好的团队短时间内也能做到。但是成千上万张 GPU,对基础设施健壮性、鲁棒性的要求是不可想象的,不止要钱,还要沉淀,也就是时间。 模型的训练与生物育种类似,需要育种专家,需要基因编辑能力或者优良的杂交亲本,也需要千亩良田。而 Google 和微软恰巧就有这千亩良田。(当然 NVIDIA 也是功不可没!)
国内有没有可能出现 Anthropic?
我的观点还是相对比较悲观的。悲观的不是能不能达到 ChatGPT 4,或者 Claude 3 现有的水平和能力,而是说能不能进入第一梯队,并保持比较强的竞争力。 达到 ChatGPT 4 能力,应该只是时间问题。有些同学预测今年就能具备同等能力,我的看法依旧不太乐观。今年在分数上可能达到甚至赶超,但是商业化的可能性不大,原因有以下几点:
- 模型结构依旧会按着 Transformer 轨迹走下去,无法摆脱强依赖 GPU 计算的现实,当下的大环境会是非常大的掣肘。国内具备千亩良田的也不少,老牌 BAT 加上字节等新秀,都是比较注重基础设施建设的。但这土壤中缺了一种关键成分,那就是 NVIDIA 的 GPU。
- NVIDIA GPU 的替代方案不会很快形成,只能用时间去弥补。
- Transformer 结构的能力极限到底在哪里?对 Transformer 的改良,无论在算法上,还是对算力需求上的优化,到底能到什么程度?这是另一个比较大的问题。前者现在看来只有美国能去探究,后者我们的机会稍多一点。但是在一个相对确定的方向上,时间沉淀不容忽视,资源的聚集效应会进一步拉大差距。 0 到 50 分很容易赶上,60 到 70 分就要咬紧牙关了。
- 是否可能出现其他模型结构的神经网络?或者非神经网络的模型算法?这就是更大的话题了,地球几亿年的进化,才出现的双螺旋结构。只能说难上加难!