Qwen3.6-27B 量化性能比较
约 2 分钟原创工程实战#quantization#qwen#inference
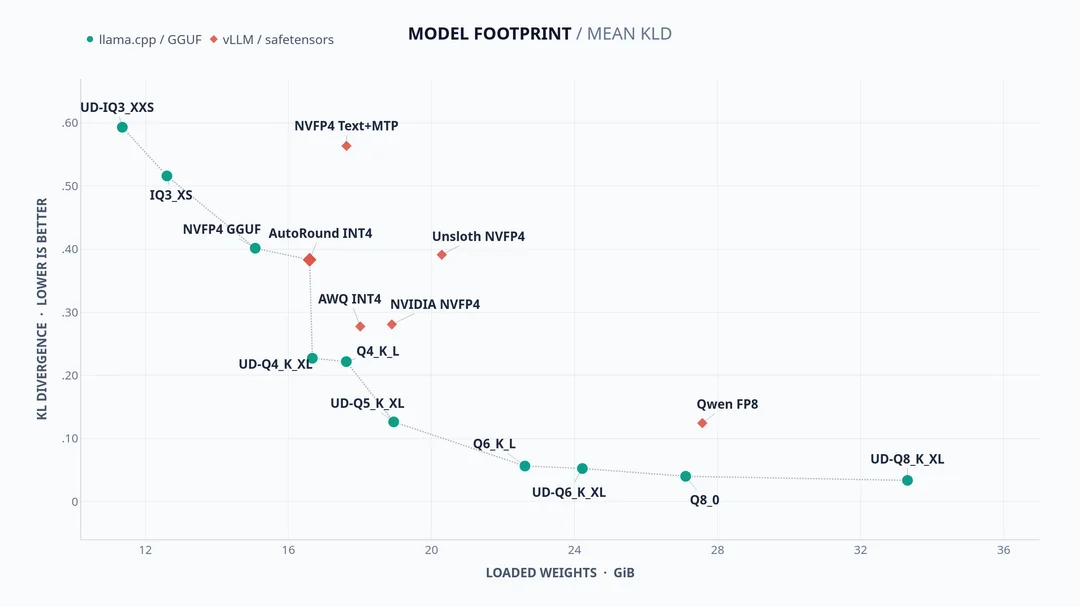
Reddit 上一个帖子对比了 Qwen3.6-27B 在不同量化方法和精度下的模型性能。
模型性能使用 KL 散度衡量,数值越小越好。基准模型应该是 Qwen3.6-27B 开源的训练精度(FP16)模型。
使用 GGUF(llama.cpp 部署,可在 PC 运行),以及其他,如 FP8、NVFP4(使用 vLLM 部署)等量化方法。
结论:
- 相同精度下,GGUF 的模型性能优于其他量化方法。
- 相同精度下,GGUF 模型的参数略大于其他量化方法。因为 GGUF 没有量化 activation 参数,这应该也是 GGUF 的模型性能更优的一个重要原因。
- 另一个 GGUF 模型性能更优的原因是,它也没有对 KV cache 进行量化。
- 但是,由此可得非 GGUF 量化在运行时 KV cache 和计算过程中使用的显存会同比例减少,这也是这些量化方法的重要优势。
- 生产环境使用 vLLM 在 GPU 上部署为主,模型性能损耗从 KL 散度来看还是蛮大的,可能上下文越长,性能衰减更明显。因此计算资源足够的情况下,还是优先全精度(FP16),感觉又说了句废话。
- 最新的 DeepSeek-v4-flash 开源即是 FP8/FP4 混合精度版本,从目前使用体验,以及 284B 的参数量和显存使用量来看,极具性价比。
上述结论,供大家部署 Qwen3.6-27B 时作为参考。